Seq-Drifting, 한 번에 전체 토큰 생성
최근 30일 조회수 —좋아요 —핵심 요약
연속 표현의 드리프트로 잡음에서 전체 토큰을 병렬 생성해 LM1B 퍼플렉서티 36.01을 기록했다.
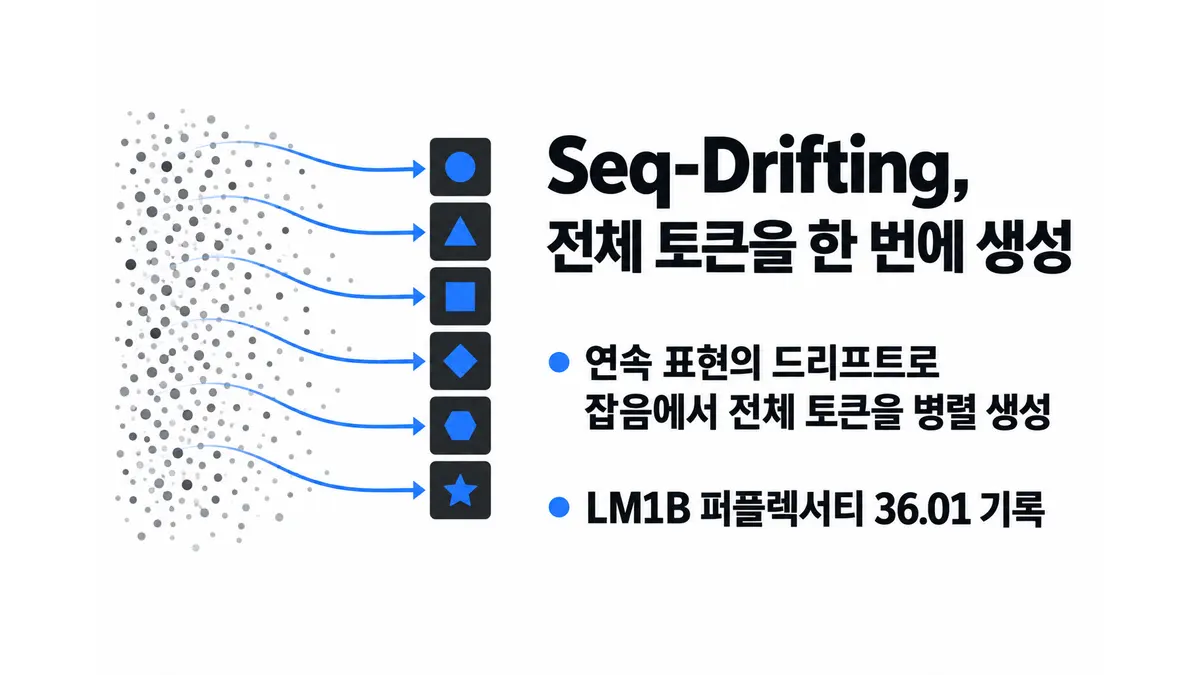
확산 언어 모델의 반복 샘플링을 한 번의 순전파로 줄이려는 생성 기법 Seq-Drifting이 10월 12일 공개됐다. 연구진은 연속적인 토큰 표현의 전체 시퀀스에 ‘드리프트’를 적용해 가우시안 잡음에서 텍스트로 직접 변환하는 방법을 제안했다. 추론할 때 모든 토큰을 병렬로 한꺼번에 생성하는 것이 목표다.1
기존 확산 언어 모델은 각 위치의 학습 목표를 관측된 토큰에서 직접 얻는다. 반면 Seq-Drifting은 현재까지 생성된 문맥에 맞춰 위치별 목표가 달라지는 드리프트 필드를 구성한다. 각 출력은 문맥상 가능한 토큰 표현 집합으로 끌어당기고, 표본 간 붕괴와 시퀀스 내부 반복은 밀어내도록 학습한다.
저자들은 LM1B에서 한 단계 생성으로 생성 퍼플렉서티 36.01을 기록했으며, 무조건·조건부 생성에서 경쟁력 있는 결과를 냈다고 보고했다. 번역·요약·추론 실험도 수행했지만, 제공된 초록에는 과제별 수치나 비교 기준이 없어 성능 우위를 판단하기는 어렵다. 이 연구는 arXiv 프리프린트 2610.12879v1이며, 코드도 공개됐다.
Footnotes
-
arXiv cs.AI, 「One-Step Text Generation by Seq-Drifting」, 2026년 10월 12일. ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- One-Step Text Generation by Seq-Drifting — arXiv cs.AI · 자료: 2026. 10. 12.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.