컴퓨터 시스템
분산 · 시스템 · 컴퓨팅
32개 기사 · 원문 자료 날짜는 각 기사에서 확인하세요.
기사 통계를 확인하고 있습니다.
덱스어텐션, 16개 GPU 학습 1.39배 가속
동적 희소 어텐션을 빠르게 재계획·분산 실행해 16개 GPU에서 학습 속도를 평균 1.39배 높였다.
NVFP4-MLA, KV 캐시·어텐션 FP4 통합
정확도를 유지하며 KV 캐시를 3배 이상 압축하고 어텐션과 에이전트 서빙 속도를 높였다.
공장 분산 AI 서버, 전력망 증설 98% 절감
생산 부하가 낮을 때 공장 간 AI 작업을 분산하면 신규 전력망 접속 용량을 최대 98% 줄일 수 있다는 연구가 나왔다.
TailGuard-GDS, GPU 꼬리 지연 최대 42.6% 감소
실행 조건별 데이터 경로를 선택하는 TailGuard-GDS가 GPU 워크로드의 꼬리 지연과 유휴시간을 줄였다.
SM 점유 없는 GPU 통신 설계 제안
Zero-SM NCCL은 통신의 SM 점유를 없애 학습 성능을 높이지만 작은 메시지에서는 한계를 보였다.
MoE 병렬화 배치, 품질 아닌 내부 결정 바꿔
MoE 학습의 병렬화 배치는 품질을 유지하면서도 라우팅과 최종 예측의 재현성을 크게 흔들었다.
CXL 공유로 LLM 콜드 스타트 단축
Cairn은 초기화 결과를 CXL 메모리로 공유해 서버리스 LLM 시작을 4.1~5.2배 가속했다.
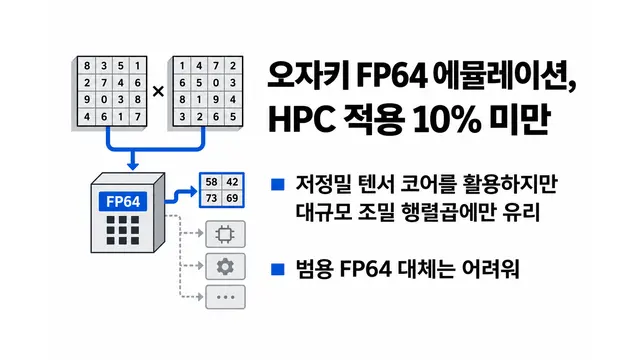
오자키 FP64 에뮬레이션, HPC 적용 10% 미만
저정밀 텐서 코어 기반 오자키 방식은 대규모 조밀 행렬곱에만 유리해 범용 FP64 대체가 어렵다는 분석이다.
SHADOWPREFILL, LLM 전환 지연 최대 21.4% 단축
후보 모델의 문맥을 미리 처리해 에이전트의 모델 전환 지연과 토큰 비용을 줄이는 기법이 공개됐다.
링크드인, GPU 작업 중개 시스템 공개
파이어풀은 웜 파드 재사용으로 AI 에이전트와 강화학습 GPU 작업의 시작 지연을 크게 줄였다.
ResServe, 잔여값 보정으로 FP4 추론 개선
ResServe는 칩 내 잔여값 보정으로 FP4 LLM 추론의 정확도를 높이면서 지연시간 증가를 억제했다.
AutoParallel, 분산 학습 설계 자동화
PyTorch 네이티브 플래너가 H100 128개 실험에서 TorchTitan 대비 처리량을 최대 18.3% 높였다.
LLM 유휴 자원 공유 위한 GPU 관리 계층 제안
연구진은 긴급한 LLM 추론을 보장하며 GPU 유휴 용량을 다른 작업에 배분하는 자원 관리 방식을 제안했다.
구글, 벡터 검색 라이브러리 GINGER 공개
GINGER는 새 양자화·압축 기술로 그래프 기반 벡터 검색의 속도와 메모리 효율을 높였다.
DMuon, 분산 행렬 옵티마이저 병목 개선
DMuon은 행렬 소유권과 통신 스케줄링으로 256개 GPU에서 AdamW 대비 중앙값 1.05배 처리량을 기록했다.
EE-RL, LLM 강화학습 GPU 에너지 16.9% 절감
EE-RL은 학습 단계별 GPU 주파수를 조절해 처리량을 유지하며 토큰당 에너지를 최대 16.9% 줄였다.
런웨이, 57B 영상 모델로 실시간 대화 구현
런웨이는 57B 영상 확산 모델을 최적화해 고해상도 대화형 캐릭터 영상을 24.5fps로 구현했다.
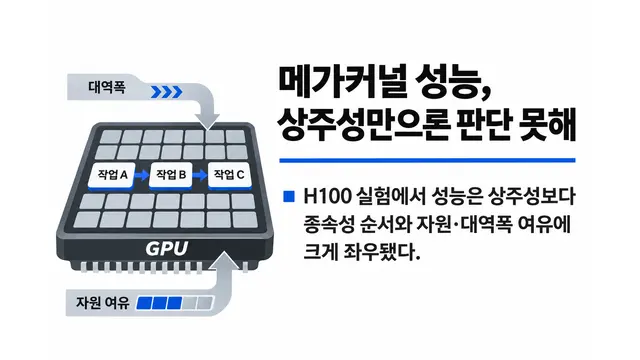
GPU 메가커널 상주성의 성능 판단 한계
H100 실험에서 메가커널의 성능은 상주성보다 종속성 순서와 자원·대역폭 여유에 크게 좌우됐다.
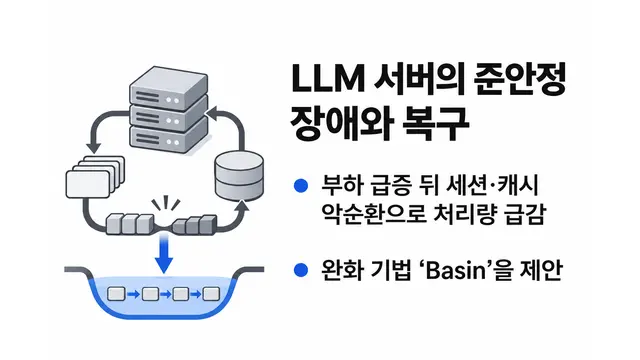
LLM 서버의 준안정 장애와 복구법
부하 급증 뒤 세션·캐시의 악순환으로 처리량이 급감하는 장애를 분석하고 완화 기법 Basin을 제안했다.
B300, 일부 AI·HPC 작업서 B200에 뒤져
B300은 일부 비전·LLM·HPC 벤치마크에서 B200보다 느렸으며 소프트웨어 버전도 성능에 큰 영향을 미쳤다.
JustGoal, B200서 전문 GPU 커널 추월
범용 AI 에이전트 JustGoal이 별도 지식·절차 없이 다수 GPU 연산에서 기존 커널보다 높은 성능을 냈다.
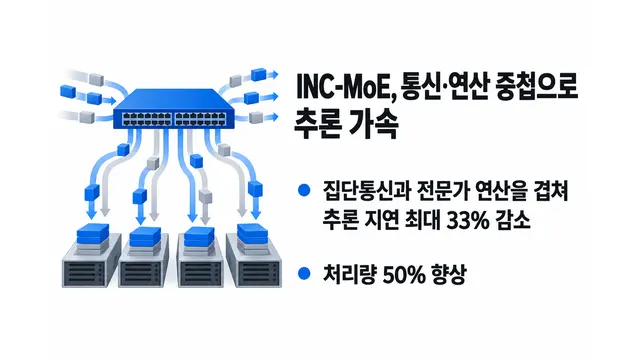
INC-MoE, 통신·연산 중첩으로 추론 가속
네트워크 내 집단통신과 전문가 연산을 겹쳐 MoE 추론의 지연을 최대 33% 줄이고 처리량을 50% 높였다.
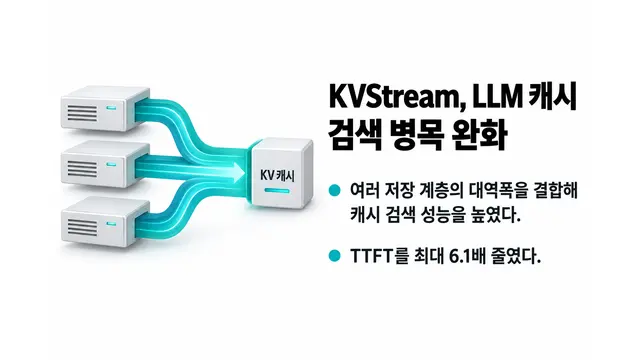
KVStream, LLM 캐시 검색 병목 완화
여러 저장 계층의 대역폭을 결합해 LLM 캐시 검색 성능을 높이고 TTFT를 최대 6.1배 줄였다.
복구 방식이 언어모델 층 가지치기 최적해 바꿔
선형 복구가 층 간 상호작용을 흡수해 언어모델 깊이 가지치기의 최적 제거 층 조합을 바꾼다는 연구가 나왔다.
이더리움 자산 보호용 PQ-볼트 제안
연구진이 이더리움 규칙 변경 없이 양자 공격에 노출된 계정의 자산을 보호하는 PQ-볼트를 제안했다.
상호 증류 연합 언러닝 기법 HERD 제안
HERD는 지식 계보를 추적해 삭제 영향의 확산을 제한하면서 모델 수정 비용을 줄였다.
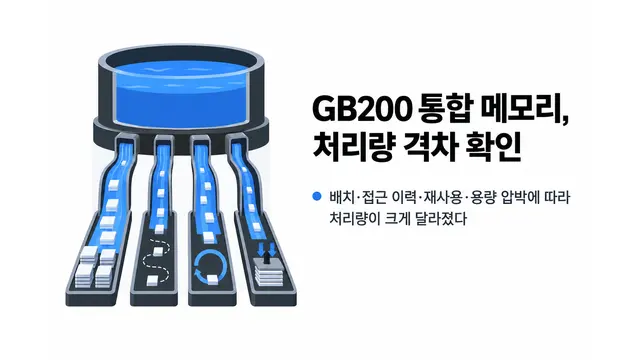
Grace-Blackwell 통합 메모리 성능 격차 확인
GB200 통합 메모리는 배치·접근 이력·재사용·용량 압박에 따라 처리량이 크게 달라졌다.
델타 토크나이저, 장기 대화 CPU 병목 완화
이전 토큰열을 재사용해 동일한 출력을 유지하면서 장기 대화 토큰화와 첫 토큰 도달 시간을 줄였다.
LLM 긴 문맥서 입력 에너지 비용 급증
LLM 프리필 에너지는 긴 문맥에서 제곱 복잡도로 급증했으며, PagedAttention은 이를 최대 8.9배 개선했다.
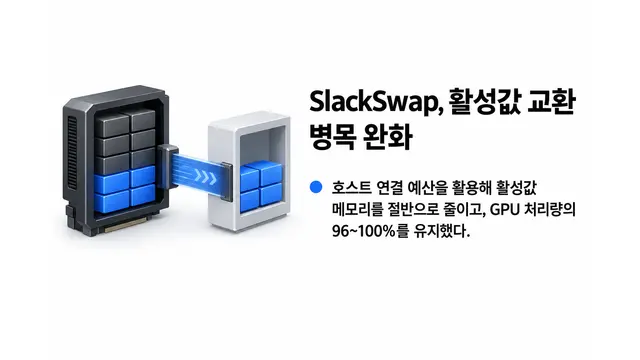
SlackSwap, 활성값 교환 병목 완화 제안
호스트 연결 예산을 활용해 활성값 메모리를 절반으로 줄이고 GPU 처리량의 96~100%를 유지했다.
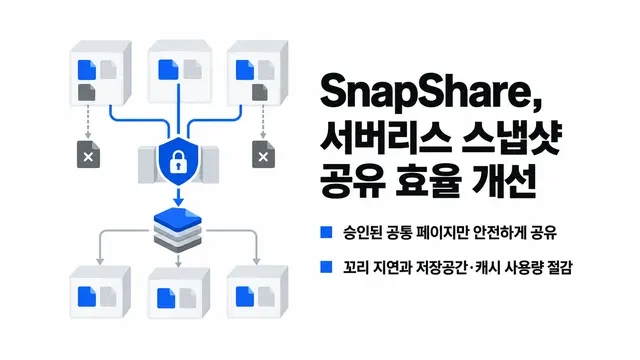
SnapShare, 서버리스 스냅샷 공유 효율 개선
승인된 공통 페이지만 안전하게 공유해 꼬리 지연과 저장공간·캐시 사용량을 줄이는 시스템이 공개됐다.
통합 멀티모달 서빙 런타임 vLLM-Omni
텍스트·음성·영상·로봇 행동 생성을 단일 파이프라인과 세션 체계로 처리하는 런타임이 제안됐다.