시계열 예측 정렬 모델 LOTUS 공개
최근 30일 조회수 —좋아요 —핵심 요약
LOTUS는 예측 기반 정렬로 시계열의 변화와 주기성을 보존해 6개 데이터셋에서 평균 정확도 59.91%를 기록했다.
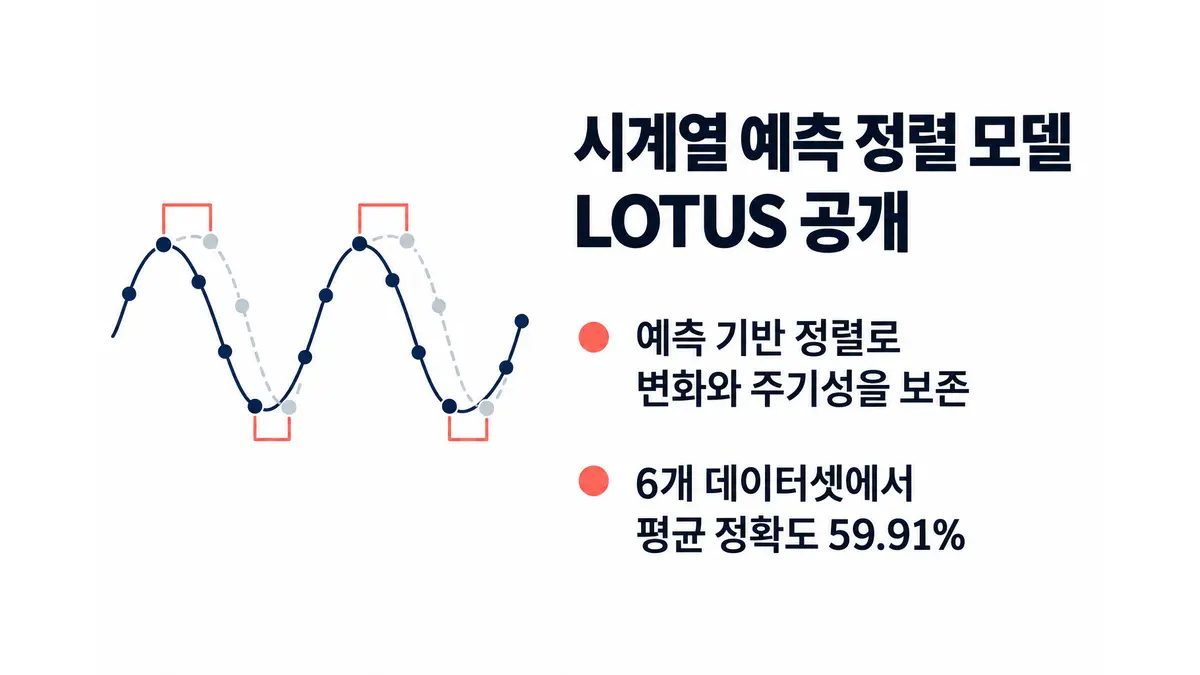
시계열의 미래를 예측하도록 언어모델을 사전학습하는 LOTUS가 공개됐다. 연구진은 숫자 신호를 라벨·설명문·질의응답과 연결하는 기존 방식이 시간에 따른 변화를 보존하도록 명시적으로 요구하지 않는다는 문제를 제기하고, ‘예측 기반 정렬(forecast grounding)’을 제안했다.
LOTUS는 시계열의 각 채널을 겹치지 않는 패치로 나눠 대규모 언어모델(LLM)의 임베딩 공간에 배치한다. 이어 시계열 토큰의 은닉 상태에서 다음 패치를 예측하게 해 시간 정보를 남긴다. 원시 패치와 주파수 영역 표현을 결합한 ‘시간-스펙트럼 패치 표현’도 사용해 변화와 주기성을 함께 포착한다.
저자들은 3개 언어모델 백본과 6개 평가 데이터셋에서 LOTUS가 평균 정확도 59.91%를 기록해 조건을 맞춘 최강 기준선보다 3.36% 높았다고 보고했다. TSRBench에서는 크기가 25~50배인 모델보다 좋은 성능을 냈으며, 표현 분석에서도 수치 입력과 시간 구조가 유지됐다고 밝혔다. 다만 초록에는 데이터셋별 결과나 학습 비용이 제시되지 않았다.
이 논문은 2026년 10월 15일 공개된 arXiv:2610.18877v1 프리프린트로, 동료 심사 여부는 확인되지 않았다.
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Lotus: Learning to Understand Time-series by Learning to Forecast — arXiv cs.LG · 자료: 2026. 10. 15.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.