순차 피드백 반영 능력 재는 Seq@K 제안
최근 30일 조회수 —좋아요 —핵심 요약
Seq@K는 언어모델이 실패 피드백을 반영해 K번 안에 문제를 해결하는 능력을 평가한다.
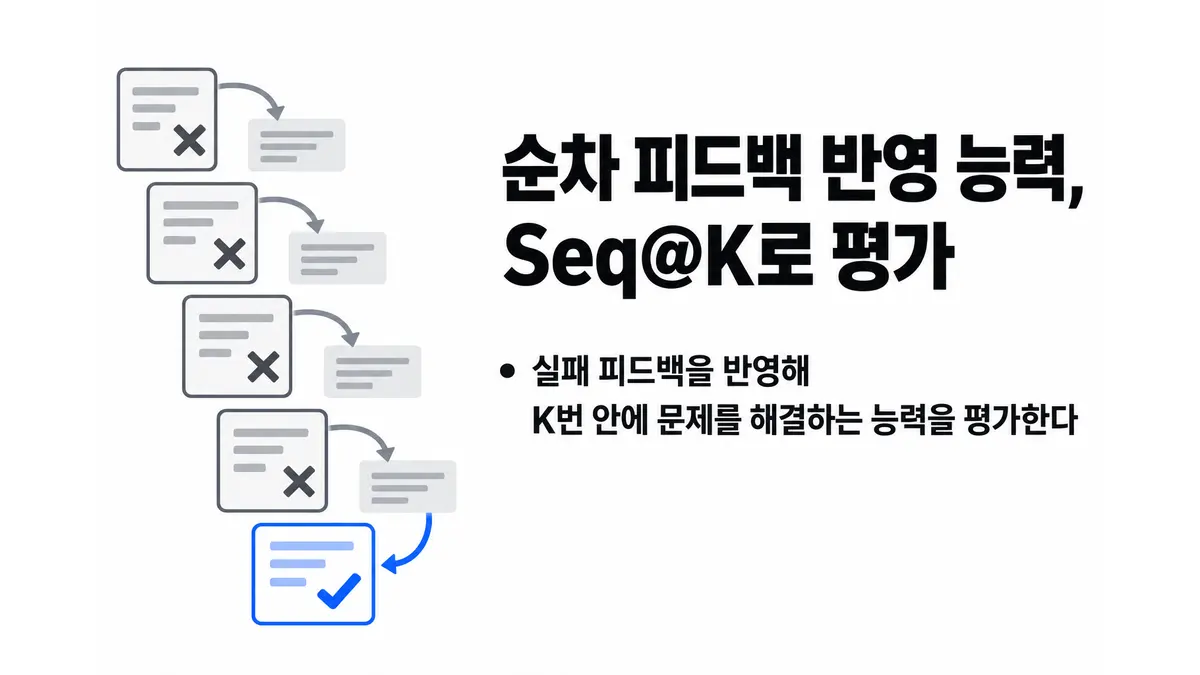
언어모델이 실패 뒤 받은 피드백을 다음 답변에 얼마나 잘 반영하는지 재는 평가 지표 Seq@K가 제안됐다. 2026년 10월 31일 공개된 arXiv 프리프린트 2610.37859v1에서 연구진은 기존 Pass@1·Pass@K가 이전 시도의 피드백을 활용해 답을 고치는 능력을 포착하지 못한다고 지적했다.1
Seq@K는 모델이 매번 실패한 뒤 피드백을 받은 상태에서, 순차적인 K번의 시도 안에 문제를 해결하는지를 측정한다. 장기 계획 능력을 다루는 다중 턴 에이전트 벤치마크와 달리, 피드백을 바탕으로 답을 개선하는 능력 자체를 분리해 평가한다.
연구진이 벤치마크 7개와 프런티어 모델 16종에 적용한 결과, Seq@K에서는 Pass@K와 모델 순위가 자주 달라졌고, 비용·성능의 파레토 전선에서도 더 효율적인 구성이 나타났다. 최적 모델 구성을 선택했을 때 얻는 이득 역시 Pass@K 기준보다 커지거나 작아졌다. 답변 궤적을 분석하면 모델이 지적된 문제를 고치는 속도와 기존 답을 고수하는 정도도 살필 수 있었다.
다만 피드백의 성격에 따라 개선 양상이 달라져, 실제 에이전트 시스템에서는 피드백 순환 구조 자체를 설계하고 따로 검증해야 한다. 이 논문은 arXiv 프리프린트다. 논문 보기
Footnotes
-
arXiv cs.AI, “Seq@K: Evaluating Language Models Under Sequential Feedback” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Seq@K: Evaluating Language Models Under Sequential Feedback — arXiv cs.AI · 자료: 2026. 10. 31.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.