단일 정답 평가, LLM 테스트 품질 과대평가
최근 30일 조회수 —좋아요 —핵심 요약
TestPrism 연구에서 단일 정답 기준 59.67%였던 성공률이 다양한 유효 구현 검증 시 28.00%로 낮아졌다.
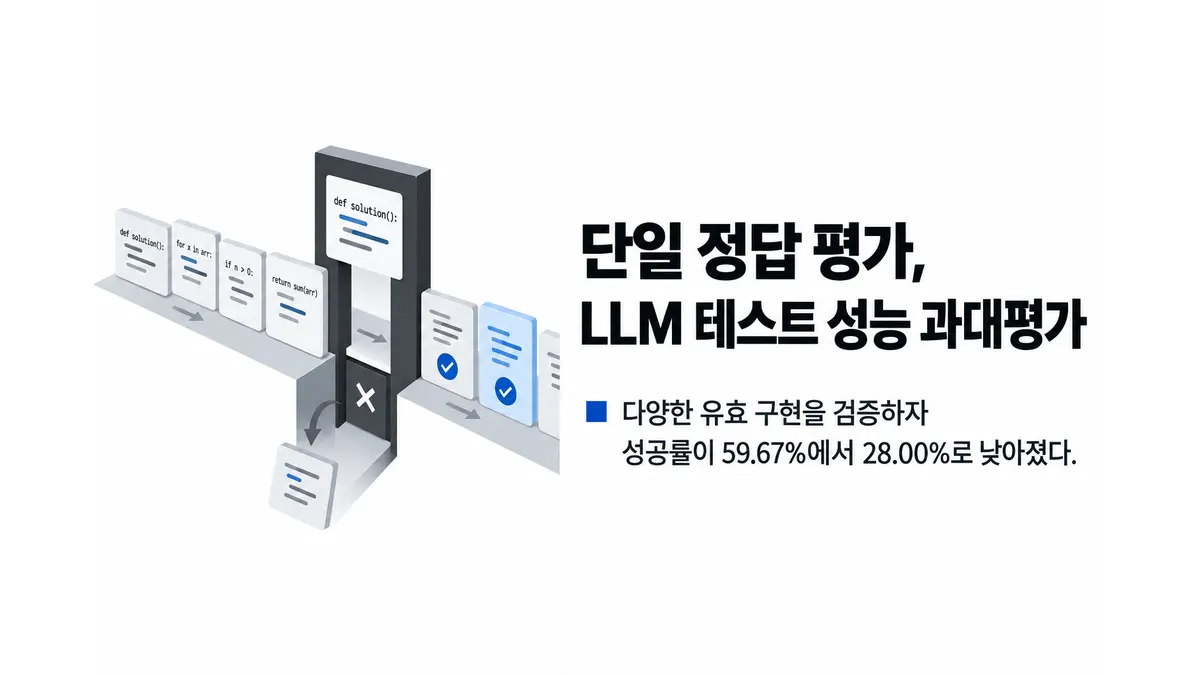
대규모 언어모델(LLM)이 만든 테스트를 단 하나의 정답 구현으로 평가하면 품질을 과대평가할 수 있다는 연구가 나왔다. 2026년 10월 9일 공개된 프리프린트 ‘TestPrism’(arXiv:2610.12289v1)은 유효하지만 정답과 다른 구현을 테스트가 잘못 거부하는 문제를 지적한다.1
연구진은 17개 출처에서 가져온 테스트 과제 300개와 후보 구현 3,000개로 TestPrism을 구성했다. 후보는 유효한 구현과 잘못된 구현이 절반씩이다. 핵심 지표인 공동 성공 함수(Joint Success Function)는 생성 테스트가 초기 프로그램에서는 실패하고, 모든 유효 후보는 통과시키며, 모든 잘못된 후보는 거부해야 성공으로 판정한다.
14개 코딩 에이전트 설정을 평가한 결과, 단일 정답 기준 성공률은 59.67%였지만 공동 성공 함수는 28.00%에 그쳤다. 연구진은 놓친 동작, 근거 없는 단언문, 잘못 구성된 테스트를 원인으로 보고했다. 이를 보완하려고 테스트·수정 쌍을 다양한 방식으로 합성하고 동료 교차 검증과 재귀적 자기 개선(RSI)을 결합한 TestHelix도 제안했다. 두 모델에서 기존 비교용 하네스보다 공동 성공 함수가 8.67~9.00%포인트 높았다.
이 결과는 저자가 보고한 TestHelix 평가 범위에 한정된다. 동료 심사 여부가 확인되지 않은 프리프린트이며, 논문 원문에서 확인할 수 있다.
Footnotes
-
arXiv cs.SE, “TestPrism: Rethinking Test Evaluation Beyond a Single Reference” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- TestPrism: Rethinking Test Evaluation Beyond a Single Reference — arXiv cs.SE · 자료: 2026. 10. 9.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.