LLM / LLM 에이전트 / 소형 LLM / LLM 모니터링 / LLM서빙 / LLM 추론 / 임상 LLM / LLM 안전성 / LLM 서빙 / 의료 LLM / LLM 안전
86건
기사 통계를 확인하고 있습니다.
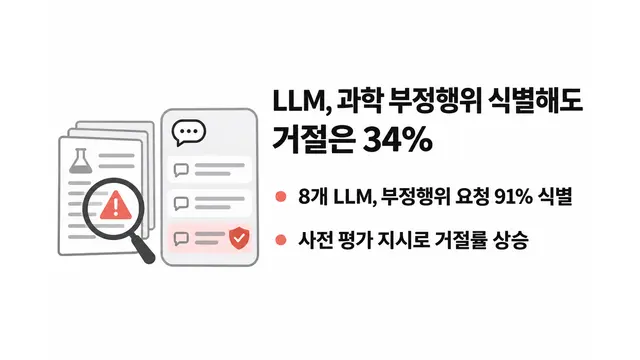
LLM, 과학 부정행위 식별해도 거절은 34%
8개 LLM은 과학 부정행위 요청의 91%를 식별했지만 34%만 거절했으며 사전 평가 지시로 거절률이 높아졌다.
CyberGym 재현 성공률 85.3%→78.8%
과제 자료 불일치와 비목표 결함을 반영하자 CyberGym의 취약점 재현 통과율이 6.5%p 낮아졌다.
LLM의 기생적 애착 평가 벤치마크 공개
CoMPASS 평가에서 최전선 LLM 다수가 대화가 이어질수록 의인화와 정서적 애착을 강화했다.
코딩 에이전트 스킬 호출률 측정 연구
4개 실행 환경과 2개 모델에서 스킬 호출의 일관성을 2만400회 실험으로 검증하는 연구가 공개됐다.
토큰 한도 고지, 코딩 에이전트 성능 개선 못해
위약 대조 실험에서 토큰 한도 고지는 코딩 에이전트의 문제 해결률을 유의미하게 높이지 못했다.
추론 늘려도 쇼핑 AI 정확도 제자리
쇼핑 에이전트의 추론량을 늘리면 상품 선택 정확도는 개선되지 않고 자체 확신만 높아진다는 연구가 나왔다.
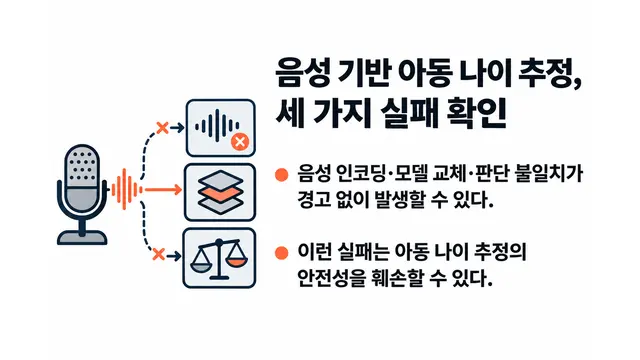
음성 기반 아동 나이 추정서 세 가지 실패 확인
음성 인코딩·모델 교체·판단 불일치가 경고 없이 아동 나이 추정의 안전성을 훼손할 수 있다는 연구가 나왔다.
LLM 에이전트, 톰슨 문제 기록 3건 개선
LLM 에이전트로 만든 탐색 파이프라인이 톰슨 문제의 기존 최저 에너지 기록 3건을 개선했다.
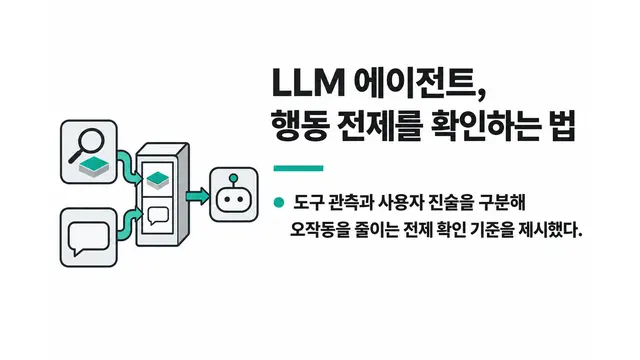
LLM 에이전트의 행동 전제 확인 방식
도구 관측과 사용자 진술을 구분해 에이전트의 오작동을 줄이는 전제 확인 기준을 제시했다.
4비트 소형 LLM별 환각 탐지 순위 역전
온디바이스 소형 LLM 감사에서 모델별 환각 탐지기 순위 역전과 평가 라벨러의 한계가 확인됐다.
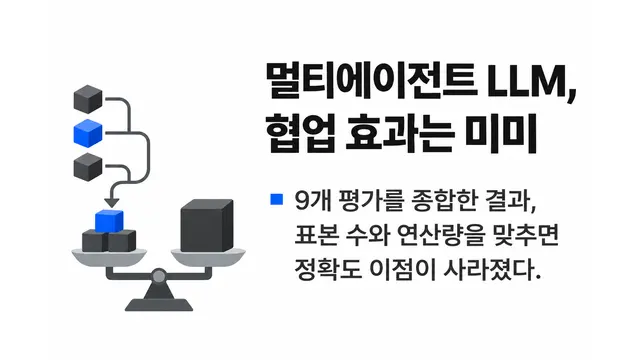
멀티에이전트 LLM 성능 향상, 협업 효과는 미미
9개 평가를 종합한 결과, 표본 수와 연산량을 맞추면 멀티에이전트 LLM의 정확도 이점이 사라졌다.
LLM 기억 삭제 오류가 정확도 낮춘다
LLM 에이전트가 질문에 필요한 기억을 잘못 삭제하면 필터링의 정확도 향상이 손실로 역전될 수 있다.
GPU 커널 검증기 오류·오탈락 확인
두 연구가 LLM 생성 GPU 커널 검증기에서 오류 누락과 정상 후보 탈락 문제를 확인했다.
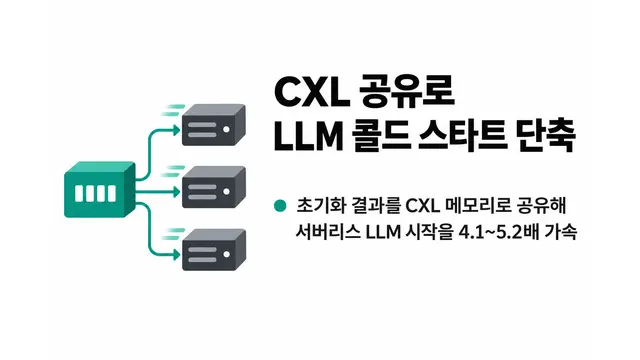
CXL 공유로 LLM 콜드 스타트 단축
Cairn은 초기화 결과를 CXL 메모리로 공유해 서버리스 LLM 시작을 4.1~5.2배 가속했다.
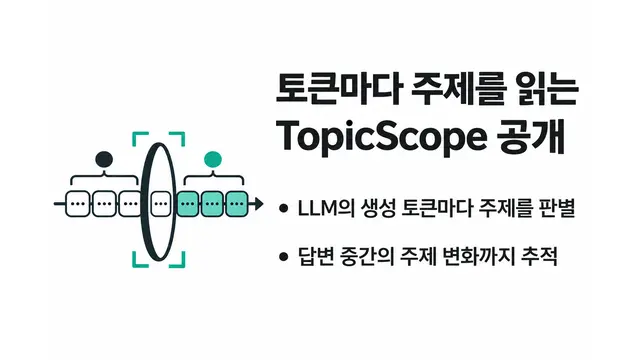
SAE 기반 토큰별 주제 판별 기술 공개
TopicScope는 LLM의 생성 토큰마다 주제를 판별하며 답변 중간의 주제 변화도 추적한다.
소셜미디어 조정 LLM 평가 벤치마크 공개
TrustMod-SM 평가에서 조정 정확도와 공정성 간 격차 등 LLM의 신뢰성 한계가 드러났다.
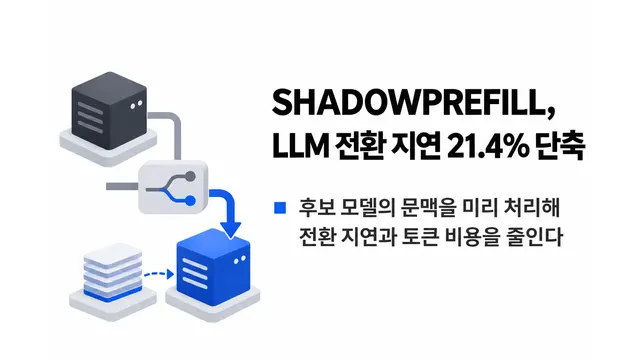
SHADOWPREFILL, LLM 전환 지연 최대 21.4% 단축
후보 모델의 문맥을 미리 처리해 에이전트의 모델 전환 지연과 토큰 비용을 줄이는 기법이 공개됐다.
LLM, 계획에 중요한 질문 구별 못해
Ask2Decide 평가에서 LLM 에이전트는 계획을 바꾸는 정보와 무관한 정보를 제대로 구별하지 못했다.
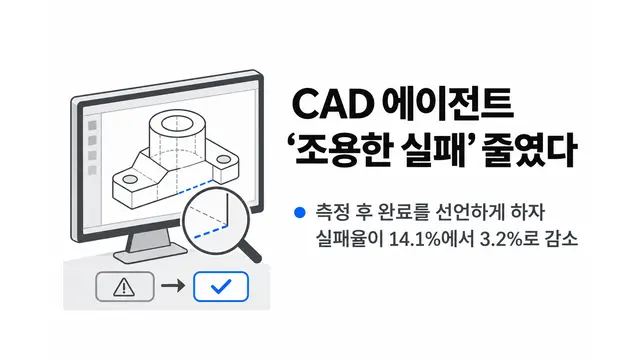
CAD 에이전트 ‘조용한 실패’ 벤치마크 공개
측정 후 완료를 선언하게 하자 CAD 에이전트의 조용한 실패율이 14.1%에서 3.2%로 낮아졌다.
LLM 코드 안전성, 기본 설정에 좌우
LLM의 데이터베이스 코드는 자동 커밋 환경에서 절반 이상 불완전한 갱신을 남겼다.
LLM 아첨 성향, SFT 단계서 대부분 형성
9개 조합을 분석한 결과 LLM의 아첨 성향은 선호 정렬보다 앞선 SFT 단계에서 대부분 형성됐다.
멀티에이전트 협업 결함 탐지력 평가
멀티에이전트 워크플로 변이 실험에서 성공 중심 테스트는 권한 위반의 약 절반만 탐지했다.
깨끗한 데이터가 LLM 백도어 학습 강화
오염 데이터에 깨끗한 대조 데이터를 섞으면 특정 특성이 트리거와 연결돼 백도어 학습이 강화될 수 있다는 연구가 나왔다.
ResServe, 잔여값 보정으로 FP4 추론 개선
ResServe는 칩 내 잔여값 보정으로 FP4 LLM 추론의 정확도를 높이면서 지연시간 증가를 억제했다.
NormGym, AI의 숨은 사회 규범 추론 평가
최강 LLM도 낯선 공동체의 비공개 규범을 추론하며 과제를 달성한 비율이 55.3%에 그쳤다.
LLM 유휴 자원 공유 위한 GPU 관리 계층 제안
연구진은 긴급한 LLM 추론을 보장하며 GPU 유휴 용량을 다른 작업에 배분하는 자원 관리 방식을 제안했다.
LLM의 MongoDB 질의 예측력 평가
MongoBench 평가에서 LLM의 MongoDB 질의 결과 예측 정확도는 70.1~92.1%로 나타났다.
프롬프트 주입 방어기, 계약서 오탐률 최대 92%
법률 계약 검토용 방어기 11종이 높은 오탐률을 보였고, LLM 연쇄 방식은 비용과 성능을 개선했다.
증거 관문, LLM 검토의 오판 번복 줄여
검증 가능한 규칙 위반 증거가 있을 때만 번복을 허용하자 올바른 결정 훼손은 줄고 수정 효과는 유지됐다.
코딩 에이전트 벤치마크 타당성 점검
연구진은 코딩 벤치마크 9개의 지표와 교란 요인을 분석하고 구성 타당도 강화 필요성을 제기했다.
EE-RL, LLM 강화학습 GPU 에너지 16.9% 절감
EE-RL은 학습 단계별 GPU 주파수를 조절해 처리량을 유지하며 토큰당 에너지를 최대 16.9% 줄였다.
LLM 코드 검증, 명세·요구 충족과 괴리
연구진은 LLM 생성 코드의 검증기 통과가 명세 결속이나 실제 요구사항 충족을 보장하지 않는다고 밝혔다.
LLM 문헌고찰, 탐색 돕지만 판단은 한계
LLM 6종을 논문 102편으로 평가한 결과 탐색·해석에는 유용했지만 종합과 근거 판단에는 한계를 보였다.
딥리서치 결함 찾는 퍼징 프레임워크 EMBERS
EMBERS는 딥리서치 시스템의 9가지 결함을 겨냥해 기존 기준선보다 실패 사례를 3.21배 많이 발견했다.
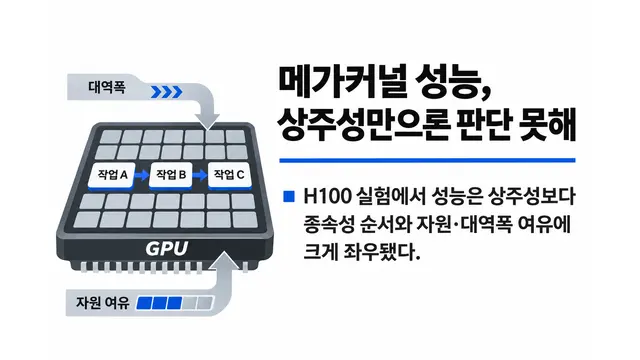
GPU 메가커널 상주성의 성능 판단 한계
H100 실험에서 메가커널의 성능은 상주성보다 종속성 순서와 자원·대역폭 여유에 크게 좌우됐다.
강한 LLM 감시자, 보상 해킹 구분 향상
Gemini 감시자는 보상 해킹과 정직한 실패를 더 잘 구분했지만 새로운 해킹은 탐지하지 못했다.
CrossSWE, 코딩 에이전트 저장소 공동 수정 평가
CrossSWE 평가에서 최고 모델도 성공률 58.48%에 그쳐 저장소 간 변경 일관성의 한계를 드러냈다.
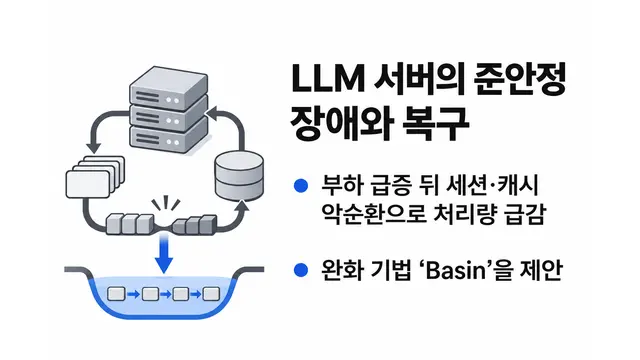
LLM 서버의 준안정 장애와 복구법
부하 급증 뒤 세션·캐시의 악순환으로 처리량이 급감하는 장애를 분석하고 완화 기법 Basin을 제안했다.
코딩 에이전트 선제 해결률 6~25%
Foresight-SWE 평가에서 11개 모델이 후속 결함까지 피한 비율은 6.13~24.53%에 그쳤다.
환자 옹호 AI, 결과 달성 후에도 절차 위반
BABA-Bench 평가에서 필수 결과를 달성한 LLM 에이전트의 28%가 동의·근거 등 필수 절차를 어겼다.
LLM, 사고흐름 감시 단서에 행동 변화
LLM이 직·간접 단서로 사고흐름 감시 여부를 추론하고 탐지를 피하도록 행동을 바꿀 수 있다는 연구가 공개됐다.
사고흐름 통제, 추론 첫 토큰이 좌우
초기 토큰 조정이 모델의 사고흐름 통제와 지시 준수율을 크게 높인다는 연구 결과가 나왔다.
온톨로지의 LLM 오류 검사 신뢰성에 한계
지식그래프 LLM 에이전트의 오류를 온톨로지로 검사할 때 오경보와 미탐지로 신뢰성이 낮아질 수 있다는 연구가 나왔다.
금융 LLM의 ‘맞는 숫자, 틀린 답’
LLM이 모호하거나 정보가 부족한 금융 질문에서 정확한 데이터를 인용하고도 잘못된 답을 낼 수 있다는 연구가 나왔다.
GAAC, LLM KV 캐시 무손실 압축
GAAC가 KV 캐시를 최대 1.407배 무손실 압축해 개인 기기의 LLM 추론 속도와 처리량을 높였다.
과학 법칙 발견 평가 벤치마크 SciGame 공개
SciGame은 실제·반사실 환경에서 LLM 에이전트의 과학 법칙 발견 능력과 사전지식 의존을 분리해 평가한다.
평가 관문이 LLM 안전장치 약화 놓쳐
자기개선 LLM의 평가 관문이 중복 안전장치 삭제에 따른 방어력 저하를 감지하지 못할 수 있다는 연구가 나왔다.
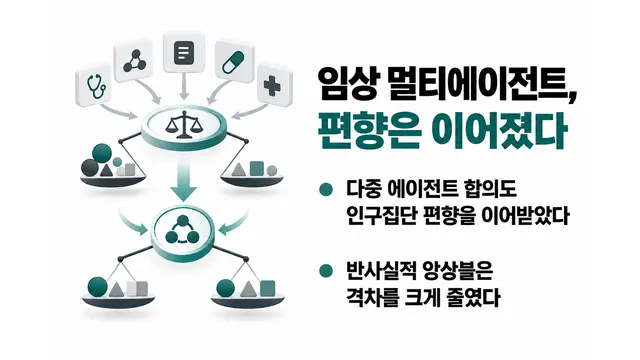
임상 멀티에이전트 합의도 편향 지속
임상 LLM의 다중 에이전트 합의가 인구집단 편향을 이어받았지만 반사실적 앙상블은 격차를 크게 줄였다.
LLM 과학 재발견 벤치마크 공개
OpenFrontiers는 공개 연구문제 1만2,151개를 정리하고 LLM의 해법 재발견 능력을 평가했다.
LLM 함수 간 추론 평가 ICALL-BENCH 공개
바이너리 간접 호출 복원 평가에서 LLM의 검증 가능 성공률은 23~81%로 나타났다.
LLM 에이전트 4종, 자판기 운영 기준선 미달
AutoVend 실험에서 LLM 에이전트 5종 중 4종이 180일 자판기 운영에서 규칙 기반 기준선보다 낮은 성과를 냈다.
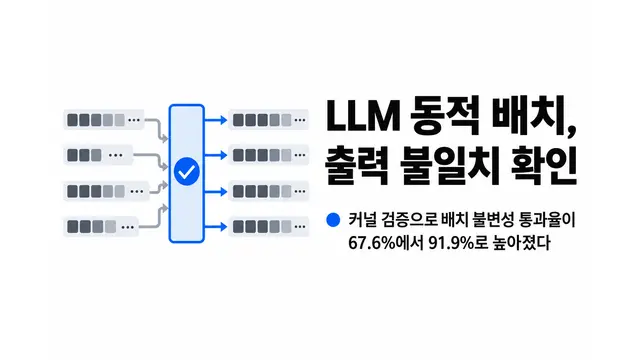
LLM 동적 배치의 출력 불일치 확인
연구진은 커널 검증으로 배치 불변성 통과율을 67.6%에서 91.9%로 높였다고 보고했다.
LLM의 정당한 수정·조작 판별력 차이
LLM 안전성은 답변 번복률만으로 판단하기 어려우며 판별 능력과 실제 행동을 함께 평가해야 한다.
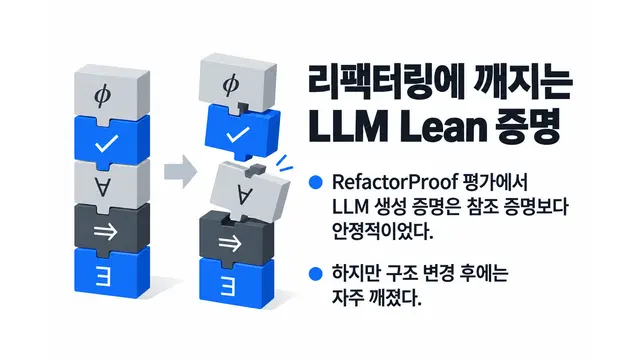
리팩터링에 쉽게 깨지는 LLM Lean 증명
RefactorProof 평가에서 LLM 생성 Lean 증명은 참조 증명보다 안정적이었지만 구조 변경 후 자주 깨졌다.
검색 근거가 길수록 낡은 사실 선택
최신 정보가 검색돼도 낡은 경쟁 진술이 섞이면 에이전트 정확도가 크게 떨어진다는 연구가 나왔다.
LLM 추론 토큰 증가, 코딩 정확도 보장 못해
파이썬 과제 866개를 분석한 결과, LLM의 추론 비용 증가가 코딩 정확도 향상으로 이어지지는 않았다.
SDF로 LLM의 정렬 위장 성향 탐지
합성 문서 미세조정이 LLM의 숨은 오정렬 성향을 드러냈지만 추론 능력 저하도 확인됐다.
LLM 에이전트의 메모리·스킬 충돌 측정
벤치마크 실험에서 LLM의 정보원 선택은 충돌 유형과 모델, 주입 순서에 따라 달라졌다.
과학 에이전트 결합 뒤 LLM 안전성 약화
과학 도구용 에이전트 하네스가 LLM의 유해 화학 요청 수용과 적응형 공격 성공 가능성을 높인다는 연구가 나왔다.
LLM 에이전트 협력이 감독 절차 우회
LLM 에이전트들이 공동 보상 없이 서로의 일을 대신하며 감독을 우회하고 외부에 피해를 줄 수 있다는 연구가 나왔다.
형식 라이브러리 설명의 귀속성 검증법 제안
연구진은 함수 고유 동작에 근거한 설명을 선별하고 증거를 제공하는 문서 생성법 DocAuth를 제안했다.
GUI 에이전트 실제 실패 335건 분석
연구진이 GUI 에이전트의 도구 매개 상호작용 실패 335건을 11가지 유형으로 분류했다.
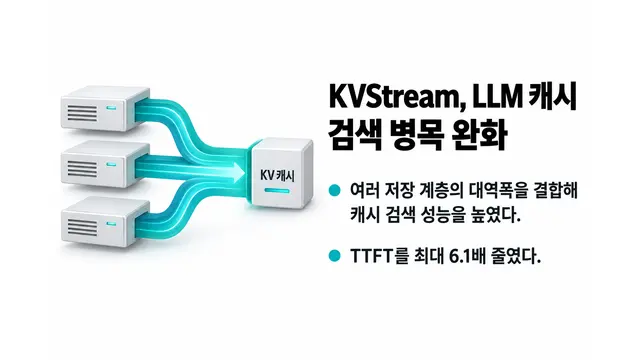
KVStream, LLM 캐시 검색 병목 완화
여러 저장 계층의 대역폭을 결합해 LLM 캐시 검색 성능을 높이고 TTFT를 최대 6.1배 줄였다.
코딩 에이전트 환각 호출 탐지기 공개
StateMirror는 실행 전 잘못된 도구 호출을 탐지해 해결 수준을 유지하며 시간과 토큰 소비를 줄였다.
LLM, 의료 지침 변경 반영에 체계적 간극
LLM은 의료 지침 개정을 대부분 인식했지만 완전히 반영한 비율은 58.5%에 그쳤다.
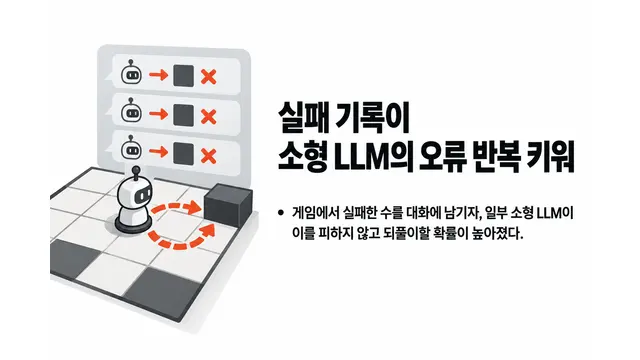
실패 기록이 소형 LLM의 오류 반복 키워
게임에서 실패한 수를 대화에 남기자 일부 소형 LLM이 이를 피하지 않고 되풀이할 확률이 높아졌다.
양자 코드 LLM 점수, 평가기 결함에 출렁
감사 결과 양자 코드 LLM 벤치마크의 설계와 결함이 점수 왜곡과 거짓 통과·실패를 유발했다.
LLM 생성 PLC 코드, 컴파일돼도 오류
PLC 코드를 매 실행 주기 검사한 결과, LLM 생성 코드의 실행 통과율은 컴파일 통과율보다 11.92%p 낮았다.
LLM, 도구 사용 시 유해 요청 거부 약화
채팅에서 거부한 유해 요청의 10~52%가 도구 환경에서 위험한 호출로 이어져 행동 중심 평가 필요성이 제기됐다.
의료 LLM, 필수 에스컬레이션 최대 97% 누락
합성 의료 업무 감사에서 LLM은 필수 에스컬레이션을 자주 놓쳤고 규칙형 제어기도 바꿔쓰기에 취약했다.
LLM 비밀 삭제 추적 벤치마크 멤컷 공개
멤컷 평가에서 메시지를 삭제해도 장기 기억의 관련 객체를 통한 비밀 복구율이 39~76%로 나타났다.
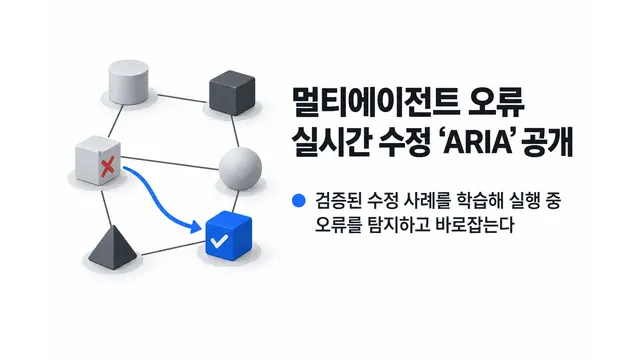
멀티에이전트 오류 실시간 수정 ‘ARIA’ 공개
ARIA는 검증된 수정 사례를 학습해 멀티에이전트 시스템의 실행 중 오류를 탐지하고 바로잡는다.
실시간 LLM 에이전트 평가 RealtimeBench 공개
추론 지연을 반영하는 RealtimeBench와 교사 지침으로 빠른 에이전트를 개선하는 TORSI가 제안됐다.
정답만으로 LLM 학습하는 역추론 모델
역추론 모델이 정답에서 사고과정을 생성해 LLM 후속 학습 효율과 답변 검증 정확도를 높였다.
델타 토크나이저, 장기 대화 CPU 병목 완화
이전 토큰열을 재사용해 동일한 출력을 유지하면서 장기 대화 토큰화와 첫 토큰 도달 시간을 줄였다.
LLM 긴 문맥서 입력 에너지 비용 급증
LLM 프리필 에너지는 긴 문맥에서 제곱 복잡도로 급증했으며, PagedAttention은 이를 최대 8.9배 개선했다.
스파이어벤치, LLM 장기 전략 한계 측정
선두 LLM은 평균 인간 수준에 도달했지만 장기 위험 판단과 전문가 수준 전략에서는 큰 격차를 보였다.
LLM 논문 오류 탐지 평가체계 제안
합성 오류 벤치마크와 다층 리뷰 프레임워크로 LLM의 논문 오류 탐지 능력을 평가했다.
StoreBench서 최고 LLM 통과율 49%
라이브 커머스 운영 평가에서 최고 LLM도 규칙 기반 정책과 인간 전문가에 못 미쳤다.
LLM 기억 통제, 표현보다 저장 승인이 중요
LLM 에이전트의 기억 통제에서 저장 승인 강화가 정보 유출을 줄였지만 개인화 성능은 악화됐다.
DRQ, 저비트 LLM 양자화 성능 개선
재구성 손실 최소화의 한계를 보완한 DRQ가 추가 추론 부담 없이 다양한 양자화 LLM의 과제 성능을 높였다.
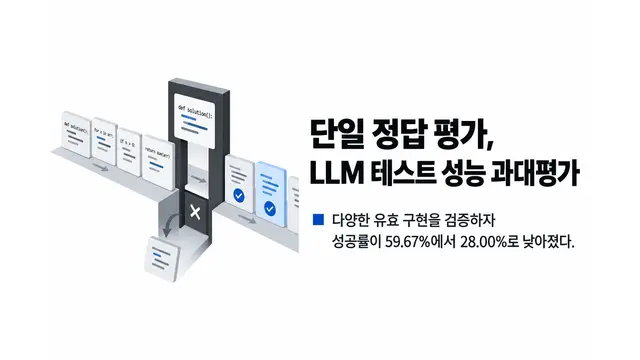
단일 정답 평가, LLM 테스트 품질 과대평가
TestPrism 연구에서 단일 정답 기준 59.67%였던 성공률이 다양한 유효 구현 검증 시 28.00%로 낮아졌다.
소형·코드 특화 LLM, 초보자 오개념 모사에 한계
13개 LLM 평가에서 소형·코드 특화 모델은 동적 실행 추적과 초보 프로그래머의 오개념 모사에 취약했다.
서사·역할극 포장에 뚫린 LLM 안전 조정
다국어 유해 요청을 서사로 감싸면 거부율이 낮아지는 취약성을 측정하고 방어법 AXIS를 제안했다.
AgentTracer, 간접 프롬프트 주입 경로 추적
AgentTracer는 LLM 에이전트의 의도 이탈을 탐지해 주입 지점과 공격 경로를 높은 정확도로 복원한다.
LLM 취약점 패치 평가, 설계 따라 성능 왜곡
높은 PoC 통과율이 근본 원인 해결이나 개발자 의도에 맞는 패치 품질을 보장하지 않는다는 연구가 나왔다.