INC-MoE, 통신·연산 중첩으로 추론 가속
최근 30일 조회수 —좋아요 —핵심 요약
네트워크 내 집단통신과 전문가 연산을 겹쳐 MoE 추론의 지연을 최대 33% 줄이고 처리량을 50% 높였다.
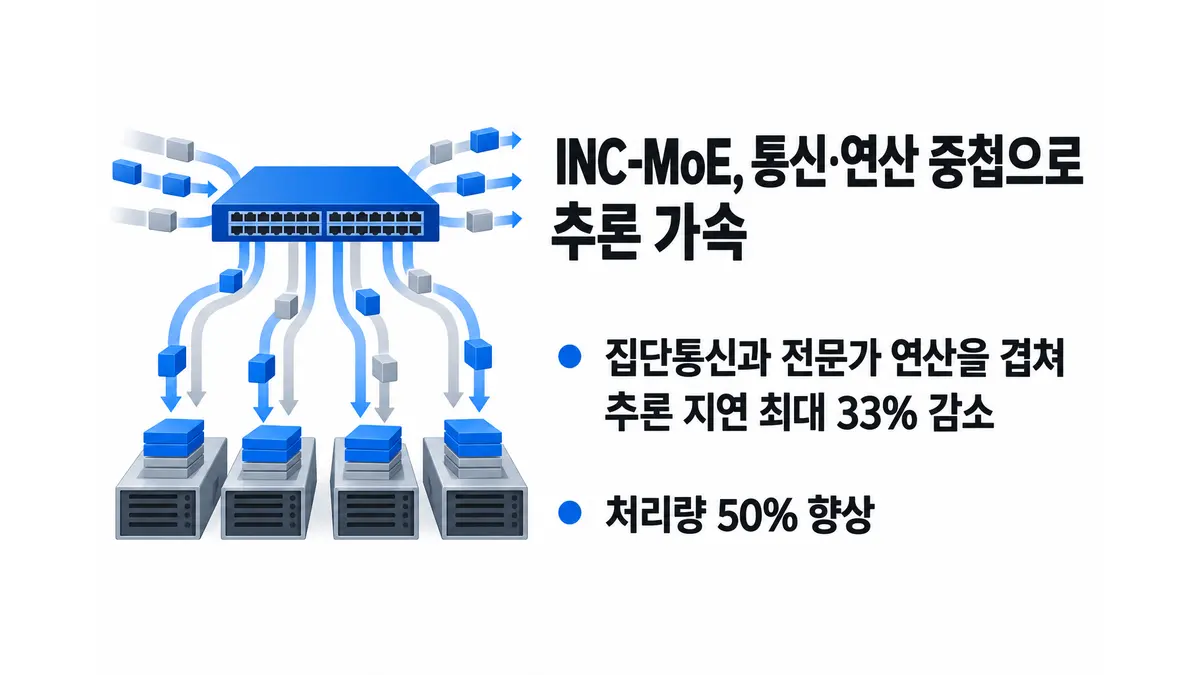
INC-MoE가 여러 노드에 걸친 전문가 병렬 혼합전문가(MoE) 추론에서 통신과 전문가 연산을 겹쳐 지연을 줄이는 방식을 제시했다. 2026년 10월 28일 공개된 arXiv 프리프린트(arXiv:2610.36339v1)다.1
MoE에서는 토큰을 선택된 전문가가 있는 가속기로 보내는 디스패치와 결과를 원래 소유자에게 돌려주는 결합이 핵심 경로를 차지한다. INC-MoE는 이를 각각 스위치 내 멀티캐스트 기반 AllGather와 축소 연산 기반 ReduceScatter로 넘긴다. 두 통신이 링크의 반대 방향을 쓰는 점을 활용해 동시에 실행하면, 대역폭이 병목인 통신 시간이 동시 링 방식보다 4개 랭크에서 33%, 8개에서 43% 줄어든다는 것이 저자들의 계산이다.
토큰은 여러 밴드로 나뉘며, 단일 상주 커널 안에서 AllGather·피드포워드 네트워크(FFN)·ReduceScatter의 3단계 파이프라인으로 처리된다. 저자들은 에뮬레이션한 4노드 환경의 OLMoE 프리필에서 vLLM 기본 통신 경로보다 첫 토큰 생성 시간(TTFT)을 최대 33% 줄이고 처리량을 최대 50% 높였으며, 출력은 일치했다고 보고했다. 다만 전용 가속기로 네트워크 내 연산 스위치를 모사한 실험이어서 실제 스위치와 더 큰 배치 환경의 성능은 초록에서 확인되지 않는다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- INC-MoE: Overlapping In-Network Collectives and Expert Computation for Expert-Parallel Mixture-of-Experts Inference — arXiv cs.DC · 자료: 2026. 10. 28.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.