MoE 병렬화 배치, 품질 아닌 내부 결정 바꿔
최근 30일 조회수 —좋아요 —핵심 요약
MoE 학습의 병렬화 배치는 품질을 유지하면서도 라우팅과 최종 예측의 재현성을 크게 흔들었다.
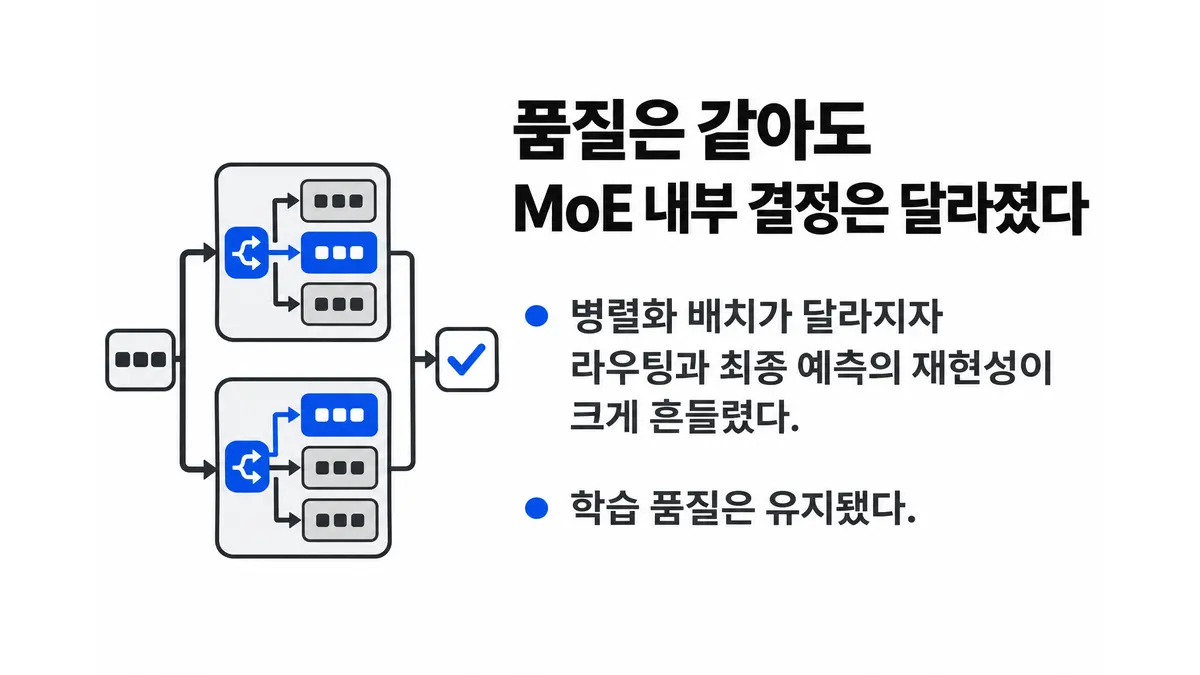
같은 데이터와 설정으로 혼합전문가(Mixture-of-Experts·MoE) 모델을 학습해도 병렬화 배치가 달라지면 최종 모델의 내부 결정은 크게 달라지지만, 품질에는 변화가 없었다는 연구가 나왔다.1 연구진은 2,500만~1억1,700만 매개변수 모델을 FineWeb-Edu 2,000만 토큰으로 사전학습하며, 데이터·전문가 병렬화 배치 9종과 무작위 시드 변경 효과를 80회 실험에서 비교했다.
배치가 달라진 모델의 최종 예측 차이는 새 시드를 썼을 때의 약 80%였고, 라우팅 결정은 90% 넘게 달라졌다. 원인은 라우터였다. 초기 16단계에서 선택이 뒤집힌 사례는 두 전문가의 점수가 거의 비슷했던 경우와 밀접하게 맞아떨어졌다(AUC 0.97~1.00). 전문가가 8개에서 64개로 늘자 근소한 점수 차이의 비율은 2.7%에서 23%로, 서로 다른 라우팅 결정은 68%에서 100%로 증가했지만 출력 차이가 더 커지지는 않았다.
같은 활성 매개변수 규모의 밀집 모델은 시드 변경 대비 차이가 fp32에서 0.12배, fp16에서 0.58배였으나 MoE는 두 정밀도 모두 약 0.8배에 두 배 빠르게 도달했다. 학습 배치를 84% 시점에 바꾸면 최종 모델 변화가 작았지만, 워밍업 직후인 10% 시점의 변경은 영향이 컸다. 이 결과는 품질이 같아도 모델 재현성은 보장되지 않음을 보여준다.
NOTE
2026년 11월 13일 공개된 arXiv:2611.15271v1 프리프린트다.
Footnotes
-
arXiv cs.DC, 「MoE Pretraining: Parallelism Layout Changes the Model, Not Quality」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- MoE Pretraining:Parallelism Layout Changes the Model, Not Quality — arXiv cs.DC · 자료: 2026. 11. 13.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.