DMuon, 분산 행렬 옵티마이저 병목 개선
최근 30일 조회수 —좋아요 —핵심 요약
DMuon은 행렬 소유권과 통신 스케줄링으로 256개 GPU에서 AdamW 대비 중앙값 1.05배 처리량을 기록했다.
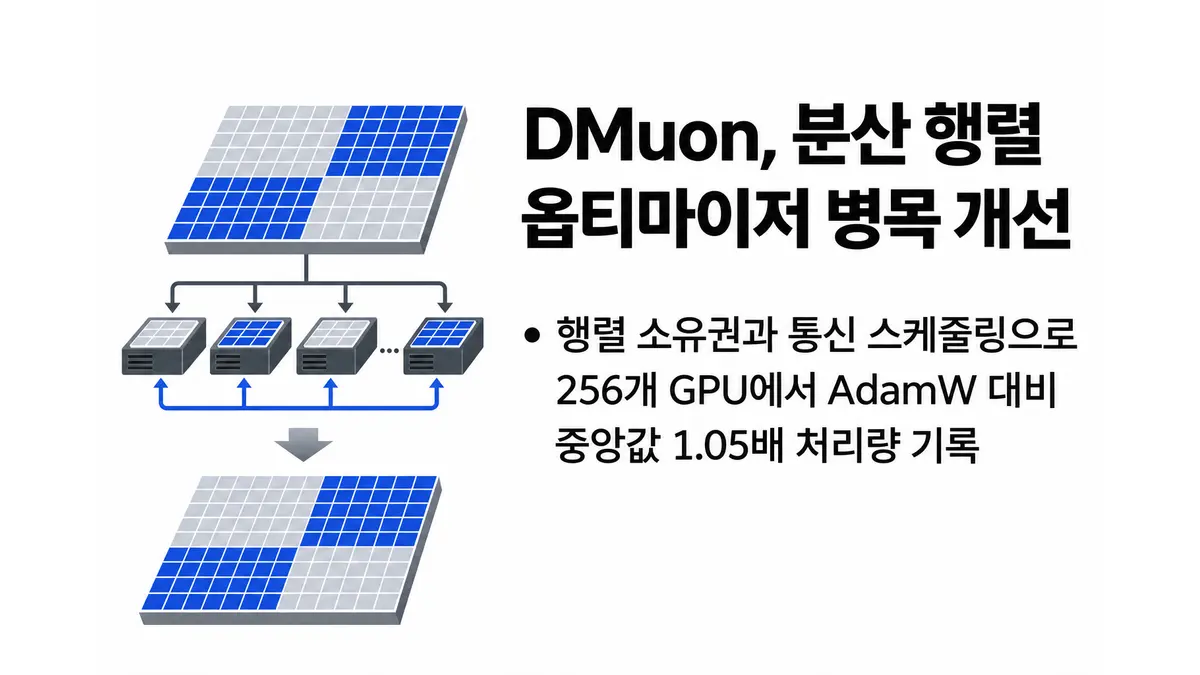
DMuon은 행렬 단위 옵티마이저와 분산 학습의 샤딩 방식이 충돌하면서 생기는 통신·중복 계산 문제를 겨냥한 런타임이다. Muon처럼 가중치 행렬 전체를 갱신하는 옵티마이저는 원소·행 단위로 매개변수를 나누는 데이터 병렬 처리에서 추가 비용을 만든다. 연구진은 이를 PyTorch FSDP(ZeRO-2/3)와 HSDP에서 작동하도록 설계했다.1
DMuon은 각 행렬에 소유자 하나를 지정해 전체 행렬의 뉴턴–슐츠(Newton–Schulz) 반복과 옵티마이저 갱신을 맡기고, 계산량에 따라 작업을 분산한다. HSDP에서는 복제본 전체에 소유권을 배정해 그래디언트와 옵티마이저 상태를 한 벌만 유지한다. 갱신된 매개변수는 준비되는 즉시 노드 간 전송하며 후속 계산과 겹쳐 처리하고, 길이가 제각각인 희소 집단 통신은 데이터 준비 시점과 2단계 네트워크 구조에 맞춰 스케줄링한다.
저자들은 H100 GPU 최대 256개, 밀집형 LLM 3종과 VLA 모델 2종에서 DMuon이 AdamW 기반 PyTorch FSDP2와 같거나 높은 학습 처리량을 냈다고 보고했다. 256개 GPU에서 중앙값은 AdamW 대비 1.05배였고, 행렬을 모은 뒤 복제하는 Muon 기준선 대비 중앙값 처리량은 2.1배였다. 다만 이는 저자가 보고한 처리량 결과다. 발표일은 2026년 11월 6일이며, 논문은 arXiv:2611.07084에서 볼 수 있다.
Footnotes
-
arXiv cs.DC, 「DMuon: Scaling Matrix Optimizers in Data Parallelism with Topology-Aware Matrix Ownership and Communication」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- DMuon: Scaling Matrix Optimizers in Data Parallelism with Topology-Aware Matrix Ownership and Communication — arXiv cs.DC · 자료: 2026. 11. 6.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.