분산학습
3건
기사 통계를 확인하고 있습니다.
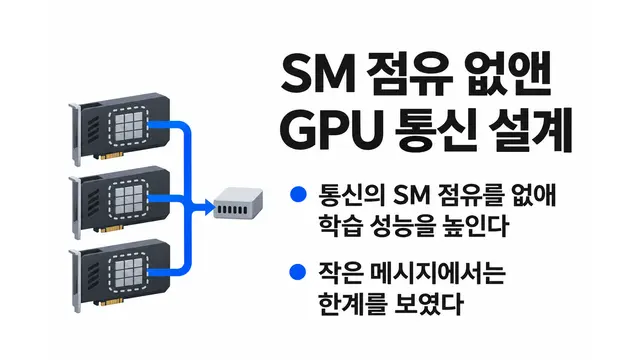
SM 점유 없는 GPU 통신 설계 제안
Zero-SM NCCL은 통신의 SM 점유를 없애 학습 성능을 높이지만 작은 메시지에서는 한계를 보였다.
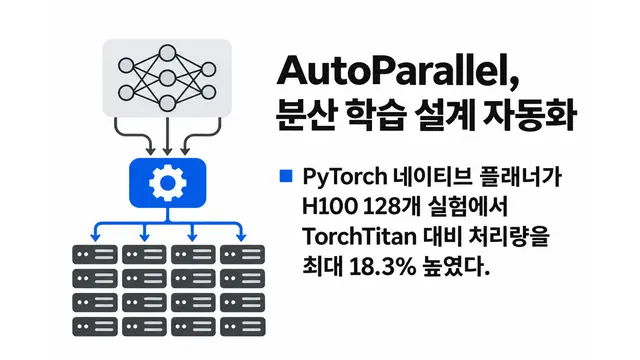
AutoParallel, 분산 학습 설계 자동화
PyTorch 네이티브 플래너가 H100 128개 실험에서 TorchTitan 대비 처리량을 최대 18.3% 높였다.
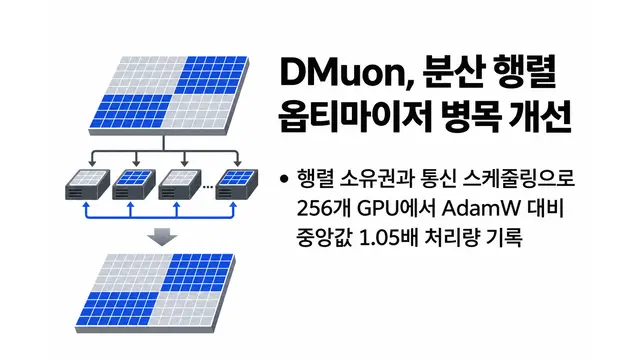
DMuon, 분산 행렬 옵티마이저 병목 개선
DMuon은 행렬 소유권과 통신 스케줄링으로 256개 GPU에서 AdamW 대비 중앙값 1.05배 처리량을 기록했다.