브래들리–테리 학습, 월드모델 확률 왜곡
최근 30일 조회수 —좋아요 —핵심 요약
비교 피드백의 브래들리–테리 목적함수가 정확한 월드모델의 결과 확률과 의사결정을 왜곡할 수 있다는 분석이 나왔다.
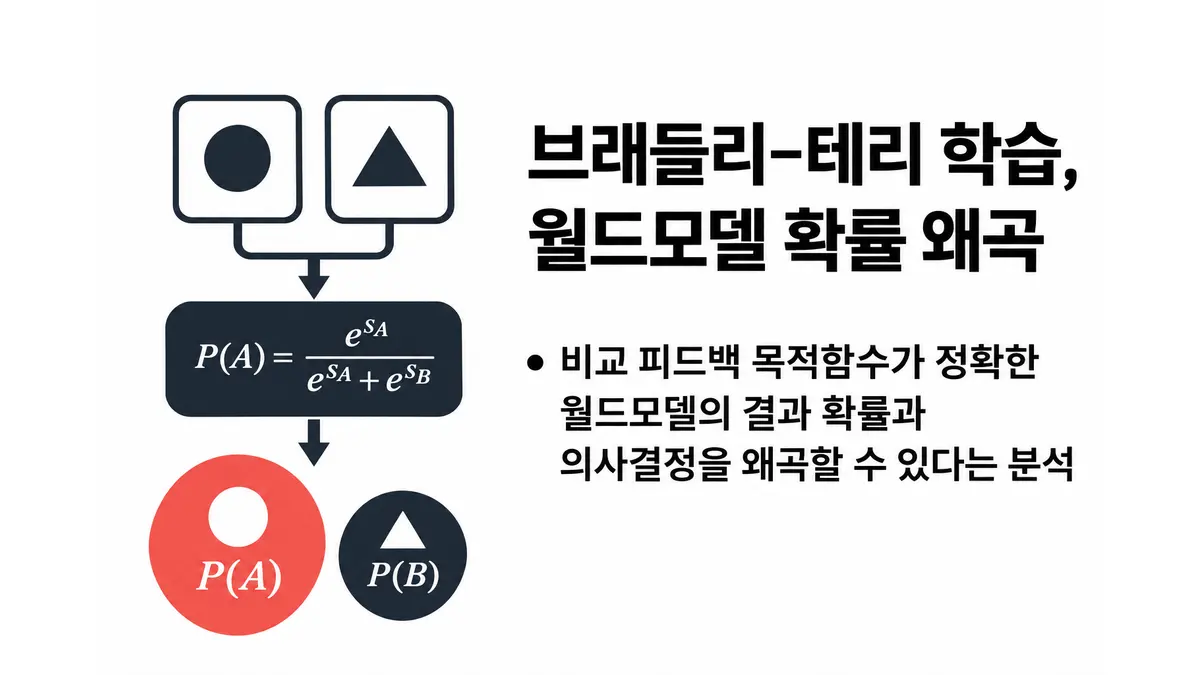
비교 피드백을 브래들리–테리(Bradley–Terry) 목적함수로 학습하면 이미 정확한 언어 월드모델의 결과 확률이 오히려 왜곡될 수 있다는 분석이 나왔다. 2026년 11월 21일 공개된 arXiv 프리프린트 arXiv:2611.25594v1은 두 후보 중 실제에 더 가까운 결과를 고르는 피드백이 참된 확률 분포를 반드시 학습시키지는 않는다고 보고했다.1
연구진은 결과 분포를 열거한 모의 로봇 밀기 실험에서, 보지 못한 배치의 위험도 오차가 2.4%포인트였던 모델을 학습시켰다. 이후 확률의 33~43%포인트가 해당 조건의 어느 분기에서도 나오지 않는 결과로 이동했다. 물리적으로 불가능한 사건을 제외해도 약 29%포인트의 이동이 남았으며, 후보 분포 다섯 종류와 3배 촘촘한 결과 열거에서도 현상이 반복됐다. 학습 전 계산한 목적함수의 최적점이 학습 후 모델을 예측했고, 판정 규칙을 반영한 우도함수는 같은 비교 자료를 쓰면서도 이런 이동을 보이지 않아 연구진은 원인을 비교 자료가 아닌 목적함수로 지목했다.
불가능한 사건을 포함하면 위험 확률이 부풀어 기존 임계값을 적용한 결정의 효용이 학습 조건에서 건당 약 3%포인트, 미관측 조건에서 1~2%포인트 줄었다. 주된 원인은 잘못된 거부였다. 불가능한 사건을 빼면 6개 시드의 평균 효용 손실은 1%포인트 미만이었지만 행동 선택에는 작은 후회값이 남았다. 이 결과는 arXiv 프리프린트로 공개됐다.
Footnotes
-
arXiv cs.LG, “Bradley-Terry Training Can Distort Outcome Probabilities of Initially Accurate Language World Models” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Bradley-Terry Training Can Distort Outcome Probabilities of Initially Accurate Language World Models — arXiv cs.LG · 자료: 2026. 11. 21.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.