대화형 CAPTCHA로 공간지능 평가
최근 30일 조회수 —좋아요 —핵심 요약
TuringSpace에서 인간은 94.1%, 최고 모델은 74.1%를 기록했으며 미세조정으로 성능이 크게 향상됐다.
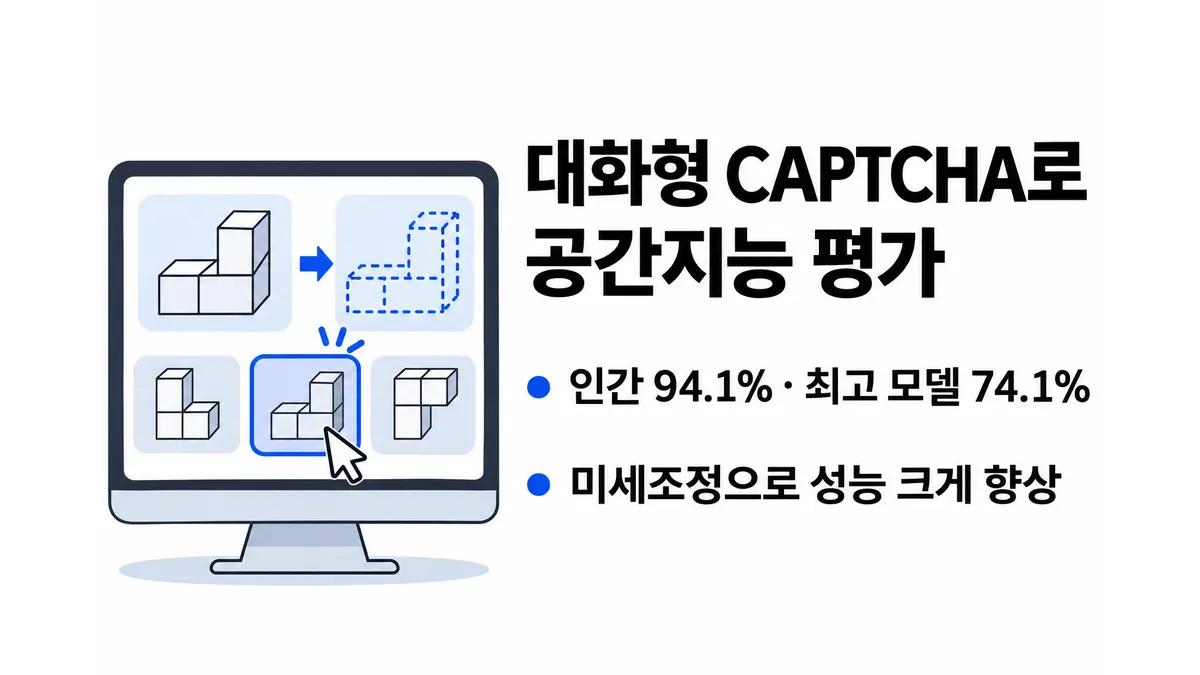
멀티모달 대규모 언어 모델(MLLM)이 화면 속 공간을 파악하고 행동 결과에 맞춰 판단을 고칠 수 있는지 평가하는 벤치마크 ‘TuringSpace’가 제시됐다. 연구진은 클릭과 드래그로 풀어야 하는 합성 대화형 CAPTCHA 125종을 만들었다. 과제는 5가지 공간 능력을 다루며, 새 사례와 채점기·정답 행동을 자동 생성하는 프로그램으로 구성됐다.1
사람의 성공률은 94.1%였다. 최고 성능 모델로 보고된 GPT-6 Astra는 74.1%를 풀었고, 최고 오픈 가중치 모델 Kimi K3의 성공률은 32.0%였다. 연구진은 실패의 대부분이 스크린샷을 잘못 읽는 데서 시작했으며, 모델이 잘못된 판단을 수정하기보다 이를 뒷받침하는 근거를 지어내는 경향을 보였다고 분석했다.
TuringSpace로 Qwen3.5-9B를 미세조정하자 성공률은 1.6%에서 33.1%로 올랐다. 분포 밖 벤치마크 7개에서도 모두 개선됐으며, 실제 실내 영상을 다루는 VSI-Bench에서는 9.9%포인트 상승했다고 저자들은 보고했다. 다만 이 결과는 2026년 11월 21일 공개된 arXiv:2611.25387v1 프리프린트에 담긴 것으로, 동료 심사 여부는 확인되지 않았다.
Footnotes
-
arXiv cs.LG, 「TuringSpace: Grounding Spatial Intelligence in Action with Interactive CAPTCHAs」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- TuringSpace: Grounding Spatial Intelligence in Action with Interactive CAPTCHAs — arXiv cs.LG · 자료: 2026. 11. 21.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.