뉴스 목록 · 16페이지
16 / 20페이지
기사 통계를 확인하고 있습니다.
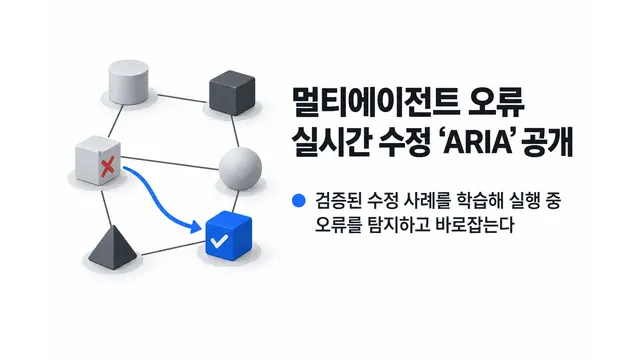
멀티에이전트 오류 실시간 수정 ‘ARIA’ 공개
ARIA는 검증된 수정 사례를 학습해 멀티에이전트 시스템의 실행 중 오류를 탐지하고 바로잡는다.
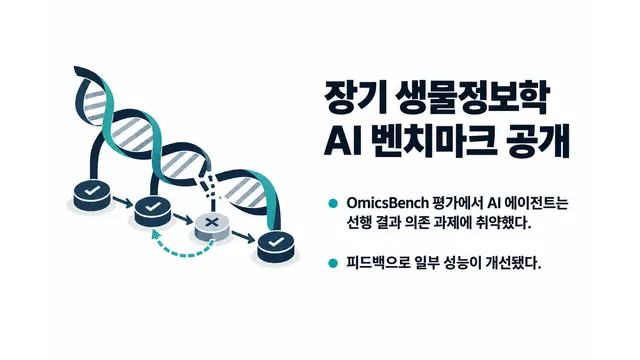
장기 생물정보학 AI 벤치마크 공개
OmicsBench 평가에서 AI 에이전트들은 선행 결과 의존 과제에 취약했고 피드백으로 일부 개선됐다.
잠재 사고흐름 해독이 추론 증거는 아니다
잠재 사고흐름의 정보와 실제 활용은 과제·학습법에 따라 다르며, 해독 가능성만으로 추론을 입증할 수 없다는 연구다.
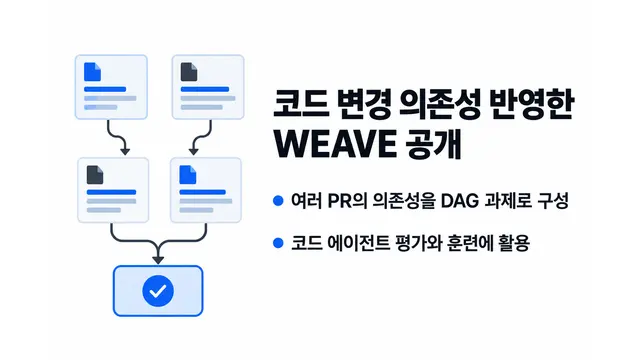
코드 변경 의존성 반영한 WEAVE 공개
WEAVE는 여러 PR의 의존성을 DAG 과제로 구성해 코드 에이전트 평가와 훈련에 활용한다.
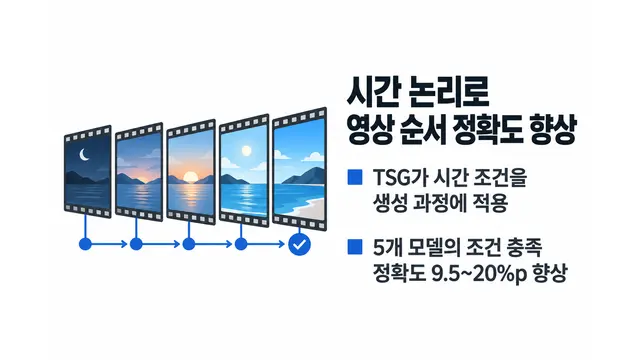
시간 논리로 영상 생성 순서 정확도 개선
TSG가 시간 조건을 생성 과정에 적용해 5개 모델의 조건 충족 정확도를 9.5~20%포인트 높였다.
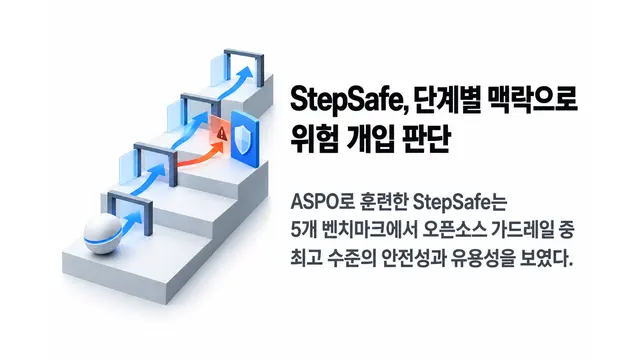
StepSafe, 단계별 맥락으로 위험 개입 판단
ASPO로 훈련한 StepSafe가 5개 벤치마크에서 오픈소스 가드레일 중 최고 수준의 안전성과 유용성을 보였다.
전체 파일 선택, 코딩 에이전트 성능 향상
CQ2-CARE는 수정할 파일의 원문 전체를 제공해 코드 압축·검색 방식보다 높은 이슈 해결률을 기록했다.
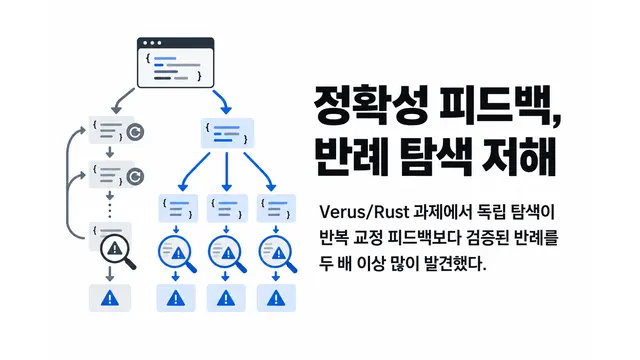
정확성 피드백이 형식 검증 반례 탐색 저해
Verus/Rust 과제에서 반복 교정 피드백보다 독립 탐색이 검증된 반례를 두 배 이상 많이 발견했다.
포화 벤치마크도 풀이 기록엔 성능 신호
정답 문항의 풀이 기록을 쌍대 비교하면 점수만 쓸 때보다 모델 역량 예측 오차가 5.3배 줄었다.
AI 작성 PR, 더 강한 검증 요구받아
개발자들은 AI 작성 PR을 덜 신뢰하며 더 강한 증거와 명확한 책임 소재를 요구한다는 조사 결과가 나왔다.
실시간 LLM 에이전트 평가 RealtimeBench 공개
추론 지연을 반영하는 RealtimeBench와 교사 지침으로 빠른 에이전트를 개선하는 TORSI가 제안됐다.
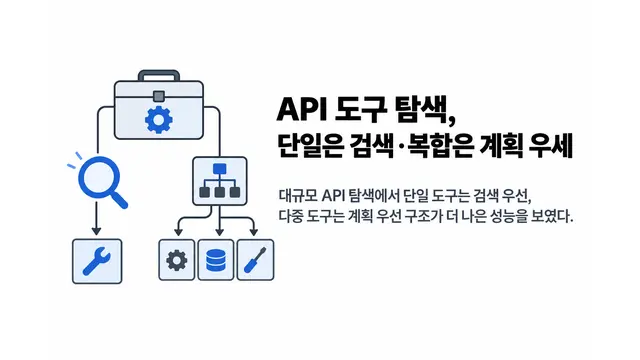
API 도구 탐색, 단일은 검색·복합은 계획 우세
대규모 API 탐색에서 단일 도구는 검색 우선, 다중 도구는 계획 우선 구조가 더 나은 성능을 보였다.