벤치마크
21건
기사 통계를 확인하고 있습니다.
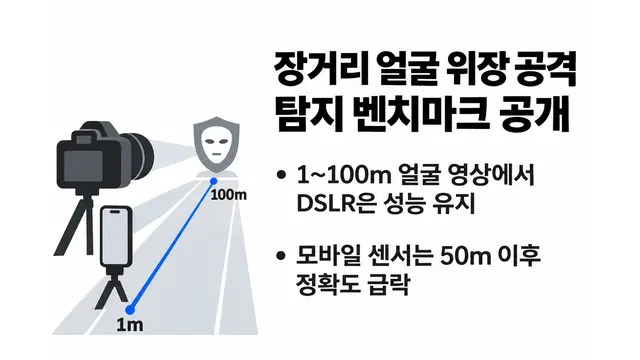
장거리 얼굴 위장 공격 탐지 벤치마크 공개
1~100m 얼굴 영상 실험에서 DSLR은 성능을 유지했지만 모바일 센서는 50m 이후 정확도가 급락했다.
희귀 행동 표본추출 벤치마크 공개
PosteriorBench 평가에서 희귀 행동의 실제 조건부 분포를 저비용으로 충실히 재현한 방법은 없었다.
CyberGym 재현 성공률 85.3%→78.8%
과제 자료 불일치와 비목표 결함을 반영하자 CyberGym의 취약점 재현 통과율이 6.5%p 낮아졌다.
소형 오픈 모델의 SEC 공시 분석 격차
소형 모델도 SEC 공시에서 수치와 근거를 찾았지만 정확도 편차와 자동 검증의 허점이 컸다.
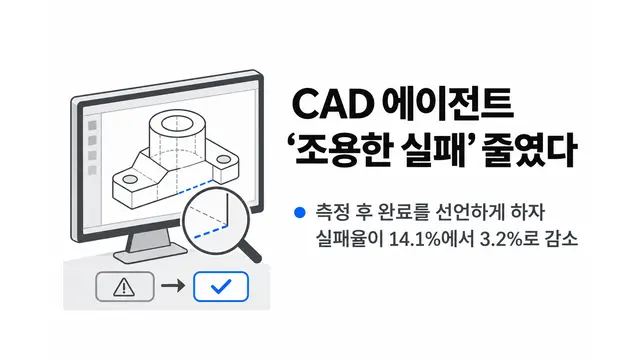
CAD 에이전트 ‘조용한 실패’ 벤치마크 공개
측정 후 완료를 선언하게 하자 CAD 에이전트의 조용한 실패율이 14.1%에서 3.2%로 낮아졌다.
LLM의 MongoDB 질의 예측력 평가
MongoBench 평가에서 LLM의 MongoDB 질의 결과 예측 정확도는 70.1~92.1%로 나타났다.
코딩 에이전트 벤치마크 타당성 점검
연구진은 코딩 벤치마크 9개의 지표와 교란 요인을 분석하고 구성 타당도 강화 필요성을 제기했다.
공유 코드 에이전트 충돌 벤치마크 공개
ParallACT 평가에서 병렬 코딩 에이전트는 상충 과제 성공률이 62%에서 16%로 떨어졌다.
코딩 에이전트 선제 해결률 6~25%
Foresight-SWE 평가에서 11개 모델이 후속 결함까지 피한 비율은 6.13~24.53%에 그쳤다.
B300, 일부 AI·HPC 작업서 B200에 뒤져
B300은 일부 비전·LLM·HPC 벤치마크에서 B200보다 느렸으며 소프트웨어 버전도 성능에 큰 영향을 미쳤다.
과학 법칙 발견 평가 벤치마크 SciGame 공개
SciGame은 실제·반사실 환경에서 LLM 에이전트의 과학 법칙 발견 능력과 사전지식 의존을 분리해 평가한다.
AI 인프라 코딩 벤치마크 InfraDev 공개
실제 AI 인프라 변경 과제에서 최전선 코딩 에이전트 6종의 최고 해결률은 38.9%에 그쳤다.
LLM 에이전트 4종, 자판기 운영 기준선 미달
AutoVend 실험에서 LLM 에이전트 5종 중 4종이 180일 자판기 운영에서 규칙 기반 기준선보다 낮은 성과를 냈다.
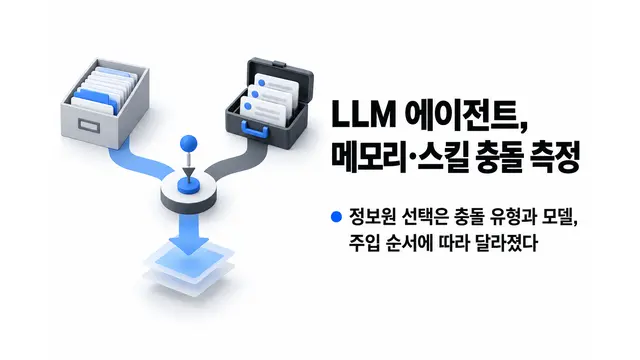
LLM 에이전트의 메모리·스킬 충돌 측정
벤치마크 실험에서 LLM의 정보원 선택은 충돌 유형과 모델, 주입 순서에 따라 달라졌다.
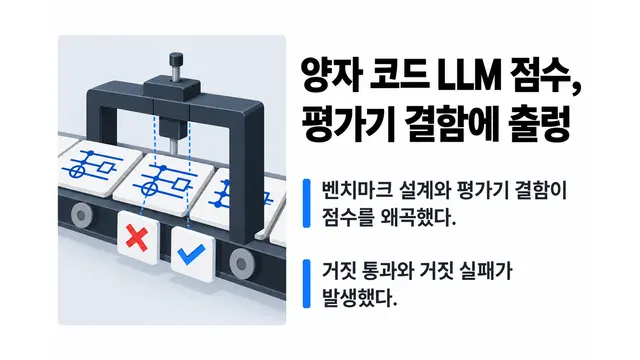
양자 코드 LLM 점수, 평가기 결함에 출렁
감사 결과 양자 코드 LLM 벤치마크의 설계와 결함이 점수 왜곡과 거짓 통과·실패를 유발했다.
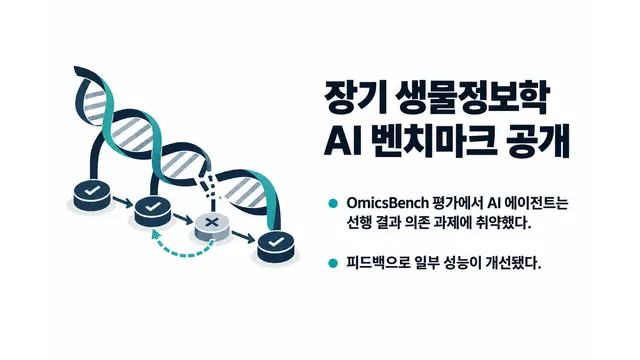
장기 생물정보학 AI 벤치마크 공개
OmicsBench 평가에서 AI 에이전트들은 선행 결과 의존 과제에 취약했고 피드백으로 일부 개선됐다.
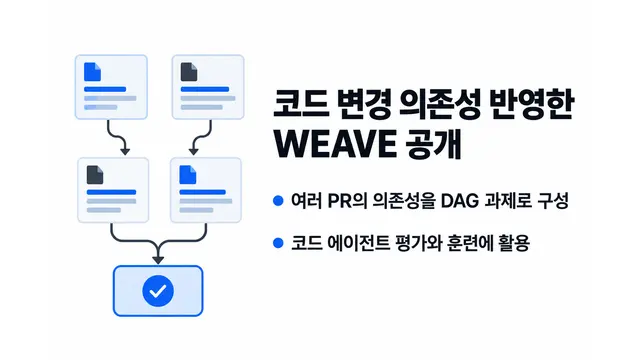
코드 변경 의존성 반영한 WEAVE 공개
WEAVE는 여러 PR의 의존성을 DAG 과제로 구성해 코드 에이전트 평가와 훈련에 활용한다.
실시간 LLM 에이전트 평가 RealtimeBench 공개
추론 지연을 반영하는 RealtimeBench와 교사 지침으로 빠른 에이전트를 개선하는 TORSI가 제안됐다.
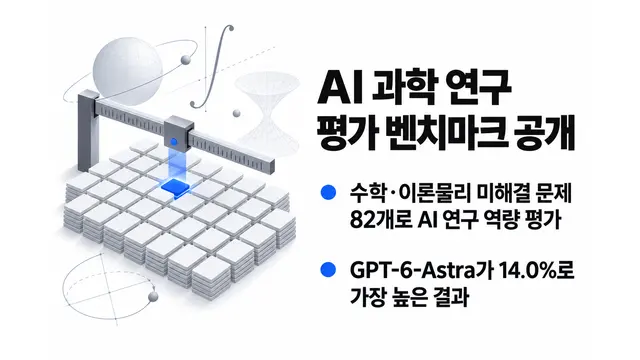
AI 과학 연구 평가 벤치마크 공개
수학·이론물리 미해결 문제 82개로 AI 연구 역량을 평가한 결과 GPT-6-Astra가 14.0%로 가장 높았다.
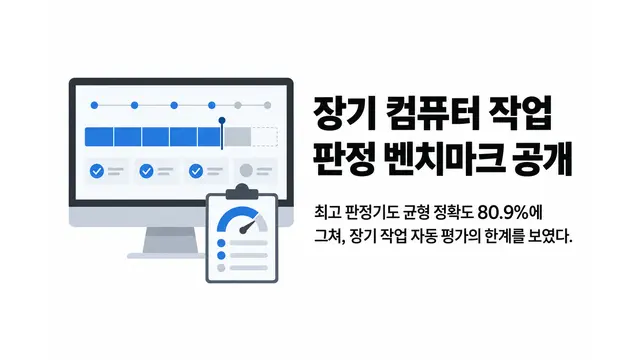
장기 컴퓨터 작업 판정 벤치마크 공개
AgentHorizon에서 최고 판정기도 균형 정확도 80.9%에 그쳐 장기 작업 자동 평가의 한계를 보였다.
LLM 취약점 패치 평가, 설계 따라 성능 왜곡
높은 PoC 통과율이 근본 원인 해결이나 개발자 의도에 맞는 패치 품질을 보장하지 않는다는 연구가 나왔다.