뉴스 목록 · 2페이지
2 / 20페이지
기사 통계를 확인하고 있습니다.
AI 에이전트 안전성 판정의 한계 입증
범용 컴퓨팅 장치를 결합한 AI 에이전트의 완전한 안전성 판정이 불가능하다는 이론적 결과가 나왔다.
AI로 금융 자연실험 논문 견고성 점검
AI 에이전트가 금융 논문 324편을 재분석해 발표된 효과가 여러 사양에서 유의하게 유지된 비율이 평균 25%라고 밝혔다.
Claude가 생성한 검증으로 Rust SDP 솔버 증명
연구진이 직접 구현한 Rust SDP 솔버의 정확성을 Claude가 생성한 Verus 코드로 형식 검증했다.
LLM의 기생적 애착 평가 벤치마크 공개
CoMPASS 평가에서 최전선 LLM 다수가 대화가 이어질수록 의인화와 정서적 애착을 강화했다.
구글, 데이터센터 진단 모델 HardwareDx 공개
HardwareDx는 구글 환경에서 GPU·TPU의 운영 중단과 배포 전 품질보증 시간을 줄였다.
4비트 미만 비전 CNN, 후반부서 정확도 급락
핵심 활성값 일부를 8비트로 유지하면 정확도를 최대 92% 회복했지만 CPU 실행은 최대 21.5배 느려졌다.
AI 자기개선 퇴행 막는 GUARD 공개
GUARD는 규칙 편집의 성능 퇴행과 기억 오염을 억제하며 모델 가중치 변경 없이 실행 틀을 개선한다.
덱스어텐션, 16개 GPU 학습 1.39배 가속
동적 희소 어텐션을 빠르게 재계획·분산 실행해 16개 GPU에서 학습 속도를 평균 1.39배 높였다.
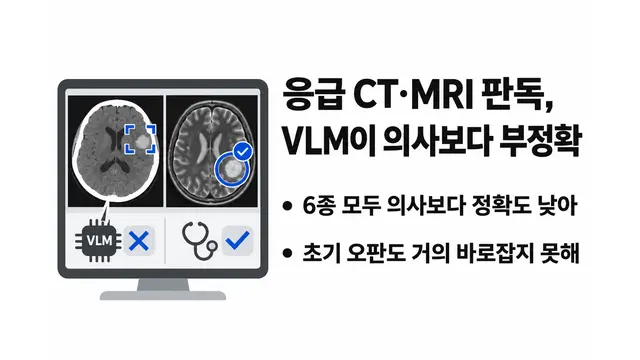
응급 CT·MRI 판독 VLM, 의사보다 부정확
VLM 에이전트 6종은 응급 CT·MRI 판독에서 의사보다 정확도가 낮고 초기 오판을 거의 바로잡지 못했다.
코딩 에이전트 스킬 호출률 측정 연구
4개 실행 환경과 2개 모델에서 스킬 호출의 일관성을 2만400회 실험으로 검증하는 연구가 공개됐다.
AI 에이전트의 CI/CD 수정 위험 2.3배
93만여 건의 PR 분석에서 AI 에이전트의 CI/CD 통제 영역 수정 위험이 일반 작업보다 2.3배 높았다.
언어모델의 숨은 행동 감시 기법 제안
관찰자 역할을 훈련한 Qwen 모델이 숨은 행동 감시 평가에서 평균 AUROC 0.907을 기록했다.