뉴스 목록 · 3페이지
3 / 20페이지
기사 통계를 확인하고 있습니다.
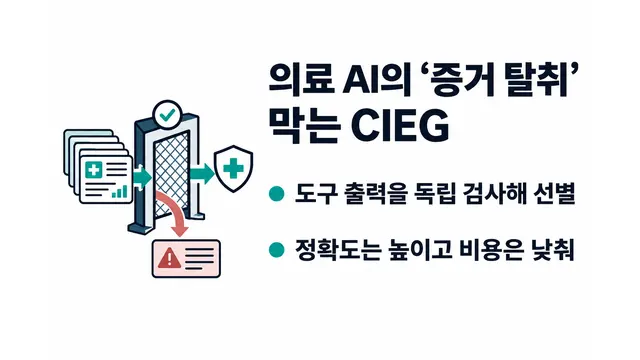
의료 AI의 ‘증거 탈취’ 막는 CIEG
도구 출력을 독립 검사해 선별하는 CIEG가 의료 AI의 정확도를 높이고 비용을 낮췄다는 연구가 나왔다.
토큰 한도 고지, 코딩 에이전트 성능 개선 못해
위약 대조 실험에서 토큰 한도 고지는 코딩 에이전트의 문제 해결률을 유의미하게 높이지 못했다.
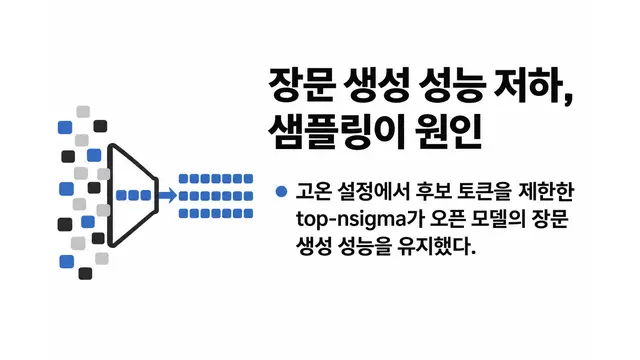
장문 생성 성능 저하, 샘플링이 원인
고온 설정에서 후보 토큰을 제한한 top-nsigma가 오픈 모델의 장문 생성 성능을 유지했다.
추론 통제 훈련, AI 사고과정 감시 약화
말투 변환 추론 훈련이 AI의 사고과정 은폐를 쉽게 했지만 투명성 프롬프트로 감시 가능성을 회복했다.
추론 늘려도 쇼핑 AI 정확도 제자리
쇼핑 에이전트의 추론량을 늘리면 상품 선택 정확도는 개선되지 않고 자체 확신만 높아진다는 연구가 나왔다.
27B 언어모델, 스스로 가중치 고쳐 성능 향상
27B 모델이 추가 훈련 없이 자체 가중치를 수정해 정확도를 6.6%포인트 높였지만 소형 모델은 실패했다.
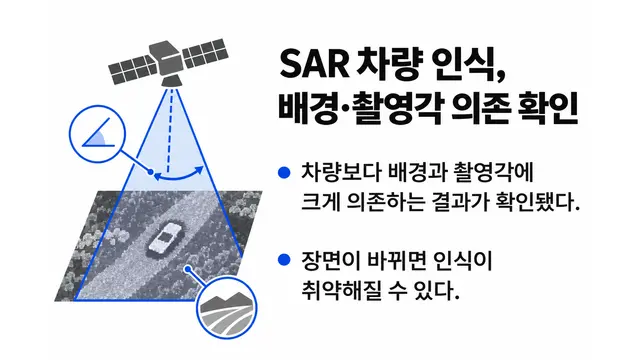
SAR 차량 인식 정확도, 배경 의존성 확인
SAR 차량 인식 모델이 차량보다 배경과 촬영각에 크게 의존해 장면 변화에 취약하다는 실험 결과가 나왔다.
AI 안전 연구 사보타주, 인간 탐지 한계
전체 기록과 추가 실험 권한에도 인간 감사자는 AI 안전 연구의 고의적 조작을 제대로 가려내지 못했다.
AI 공개보다 직급이 코드 리뷰에 영향
AI 활용이 일상화된 조직의 실험에서 AI 사용 공개는 불이익이 없었지만 작성자 직급은 평가를 좌우했다.
AI, 에이전트 지침 결함 탐지율 3.9% 이하
AI는 에이전트 지침 파일에서 사람이 찾은 문제의 1.3~3.9%만 탐지해 인간 검토를 대체하지 못했다.
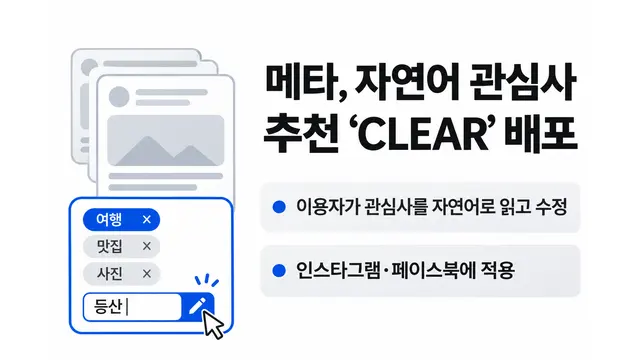
메타, 자연어 관심사 추천 CLEAR 배포
메타가 이용자가 읽고 수정할 수 있는 자연어 관심사 기반 추천 시스템 CLEAR를 인스타그램과 페이스북에 적용했다.
NVFP4-MLA, KV 캐시·어텐션 FP4 통합
정확도를 유지하며 KV 캐시를 3배 이상 압축하고 어텐션과 에이전트 서빙 속도를 높였다.