뉴스 목록 · 12페이지
12 / 20페이지
기사 통계를 확인하고 있습니다.
AI 인프라 코딩 벤치마크 InfraDev 공개
실제 AI 인프라 변경 과제에서 최전선 코딩 에이전트 6종의 최고 해결률은 38.9%에 그쳤다.
빨간 하트가 VLM의 재귀 풀이 유도
단순한 시각 기호가 VLM의 코딩 풀이와 모델 간 의사소통에 암묵적으로 영향을 준다는 예비 결과가 나왔다.
LLM 에이전트 4종, 자판기 운영 기준선 미달
AutoVend 실험에서 LLM 에이전트 5종 중 4종이 180일 자판기 운영에서 규칙 기반 기준선보다 낮은 성과를 냈다.
SNN, 모델 탈취 공격에 더 강한 내성
벤치마크에서 SNN 대리 모델은 ANN보다 판단 일치도와 적대적 예제 전이성이 낮았다.
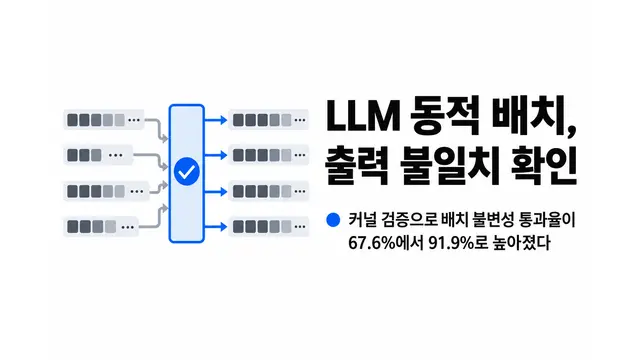
LLM 동적 배치의 출력 불일치 확인
연구진은 커널 검증으로 배치 불변성 통과율을 67.6%에서 91.9%로 높였다고 보고했다.
LLM의 정당한 수정·조작 판별력 차이
LLM 안전성은 답변 번복률만으로 판단하기 어려우며 판별 능력과 실제 행동을 함께 평가해야 한다.
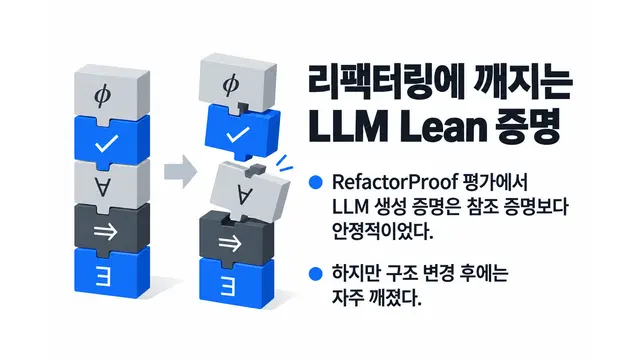
리팩터링에 쉽게 깨지는 LLM Lean 증명
RefactorProof 평가에서 LLM 생성 Lean 증명은 참조 증명보다 안정적이었지만 구조 변경 후 자주 깨졌다.
AI 생성 웹글, 영어·상업 페이지에 집중
500만여 웹페이지 분석 결과 AI 글은 영어·상업 도메인·연결성이 낮은 페이지에서 더 흔했다.
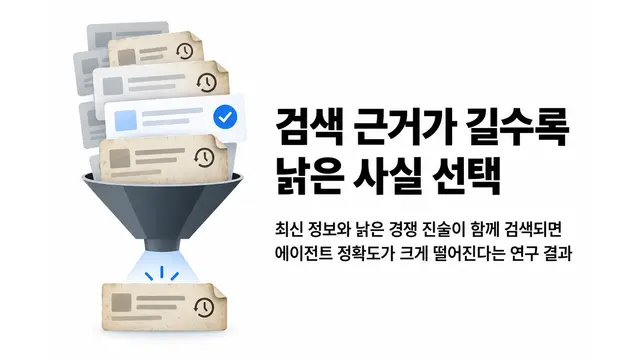
검색 근거가 길수록 낡은 사실 선택
최신 정보가 검색돼도 낡은 경쟁 진술이 섞이면 에이전트 정확도가 크게 떨어진다는 연구가 나왔다.
AI 코딩으로 PR 2배, 리뷰 부담도 2배
AI 코딩 도구가 개발자의 PR 처리량을 늘렸지만 리뷰어 부담도 2배로 키웠다는 연구가 나왔다.
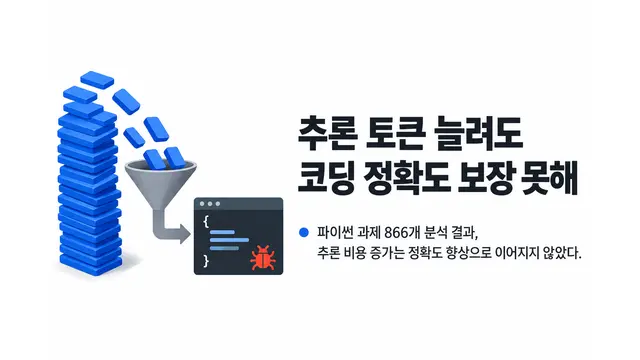
LLM 추론 토큰 증가, 코딩 정확도 보장 못해
파이썬 과제 866개를 분석한 결과, LLM의 추론 비용 증가가 코딩 정확도 향상으로 이어지지는 않았다.
효과 유형 학습으로 도구 호출 안전성 향상
이펙트월드로 학습한 Qwen3-4B가 위험한 도구 호출을 줄이며 과제 성공률과 효율을 높였다.