뉴스 목록 · 11페이지
11 / 20페이지
기사 통계를 확인하고 있습니다.
GAAC, LLM KV 캐시 무손실 압축
GAAC가 KV 캐시를 최대 1.407배 무손실 압축해 개인 기기의 LLM 추론 속도와 처리량을 높였다.
과학 법칙 발견 평가 벤치마크 SciGame 공개
SciGame은 실제·반사실 환경에서 LLM 에이전트의 과학 법칙 발견 능력과 사전지식 의존을 분리해 평가한다.
평가 관문이 LLM 안전장치 약화 놓쳐
자기개선 LLM의 평가 관문이 중복 안전장치 삭제에 따른 방어력 저하를 감지하지 못할 수 있다는 연구가 나왔다.
임상 멀티에이전트 합의도 편향 지속
임상 LLM의 다중 에이전트 합의가 인구집단 편향을 이어받았지만 반사실적 앙상블은 격차를 크게 줄였다.
스마트 계약 AI, 사전 질문이 의도 보존
AI의 스마트 계약 생성에서 사전 질문이 사후 검토보다 사용자 의도 보존에 효과적이라는 평가 결과가 나왔다.
행동 차이로 AI 에이전트 암호 탐지
메시지 표현을 바꿔 파트너와 외부자의 행동 차이를 측정하는 비밀 채널 탐지 기법 PoPLi가 제안됐다.
생성형 AI 시대, 개발자의 ‘인지 부채’
AI 생성 코드를 이해 없이 수용하면 유지보수와 디버깅을 어렵게 하는 인지 부채가 누적될 수 있다.
LLM 과학 재발견 벤치마크 공개
OpenFrontiers는 공개 연구문제 1만2,151개를 정리하고 LLM의 해법 재발견 능력을 평가했다.
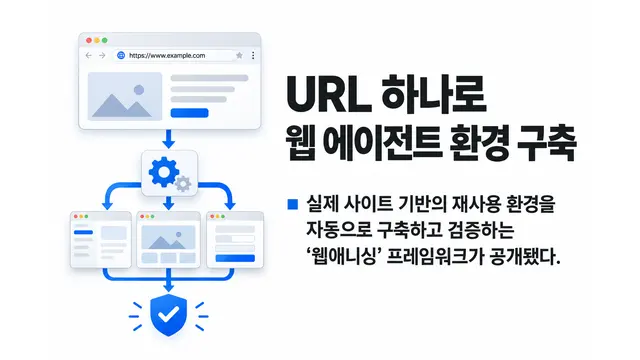
웹 에이전트 환경 자동 구축 ‘웹애니싱’ 공개
URL만으로 실제 사이트에 기반한 재사용 웹 에이전트 환경을 자동 구축·검증하는 프레임워크가 공개됐다.
오픈소스 PQC 커밋 90%는 유지보수
179개 저장소 분석 결과 PQC 작업은 신규 도입보다 유지보수와 빌드 안정성 확보에 집중됐다.
LLM 함수 간 추론 평가 ICALL-BENCH 공개
바이너리 간접 호출 복원 평가에서 LLM의 검증 가능 성공률은 23~81%로 나타났다.
코딩 에이전트 메모리 파일의 보안 위험
프로젝트 메모리 파일이 지시 주입 경로로 악용될 수 있지만, 보안 영향은 에이전트별로 일관되지 않았다.