뉴스 목록 · 18페이지
18 / 20페이지
기사 통계를 확인하고 있습니다.
코딩 에이전트 테스트 결함 탐지력 60% 미만
TestSuiteBench에서 최신 코딩 에이전트는 테스트 통과율은 높았지만 변이 점수 60%를 넘지 못했다.
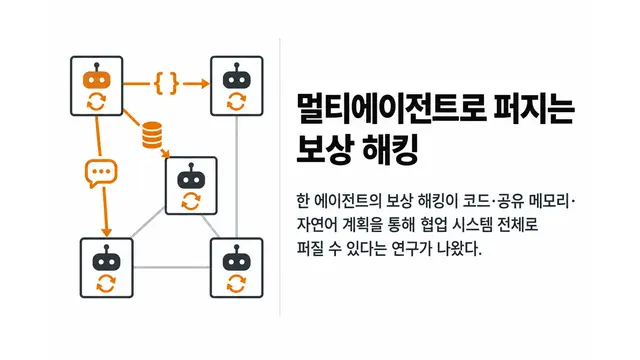
멀티에이전트에 전파되는 보상 해킹
한 에이전트의 보상 해킹이 코드·공유 메모리·자연어 계획을 통해 협업 시스템 전체로 퍼질 수 있다는 연구가 나왔다.
LLM 논문 오류 탐지 평가체계 제안
합성 오류 벤치마크와 다층 리뷰 프레임워크로 LLM의 논문 오류 탐지 능력을 평가했다.
StoreBench서 최고 LLM 통과율 49%
라이브 커머스 운영 평가에서 최고 LLM도 규칙 기반 정책과 인간 전문가에 못 미쳤다.
LLM 기억 통제, 표현보다 저장 승인이 중요
LLM 에이전트의 기억 통제에서 저장 승인 강화가 정보 유출을 줄였지만 개인화 성능은 악화됐다.
AI 과학 연구 평가 벤치마크 공개
수학·이론물리 미해결 문제 82개로 AI 연구 역량을 평가한 결과 GPT-6-Astra가 14.0%로 가장 높았다.
자기개선 에이전트와 검증기 공동 진화
실패 탐지기를 조합해 검증기를 함께 개선하는 ‘더블 래칫’이 세 과제에서 기준 평가의 88~110% 성능을 유지했다.
TGIT, 항공 VLN 지시 격차 줄였다
TGIT가 짧은 사용자 지시를 실행 가능한 명령으로 번역해 동결된 항공 VLN 에이전트의 성공률을 높였다.
DRQ, 저비트 LLM 양자화 성능 개선
재구성 손실 최소화의 한계를 보완한 DRQ가 추가 추론 부담 없이 다양한 양자화 LLM의 과제 성능을 높였다.
도구 에이전트의 ‘선택적 망각’ 기법 제안
도구 결과를 복구 가능하게 보관해 문맥과 비용을 줄였지만 효과와 품질은 작업 특성에 따라 달랐다.
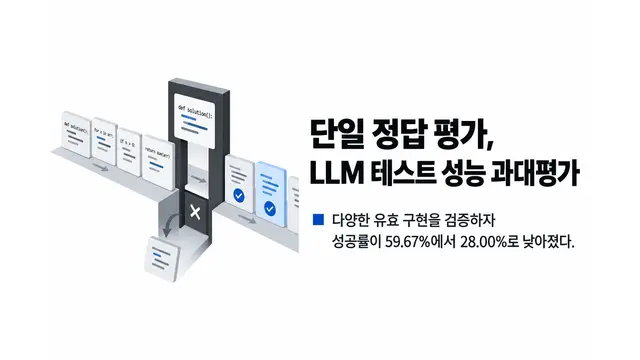
단일 정답 평가, LLM 테스트 품질 과대평가
TestPrism 연구에서 단일 정답 기준 59.67%였던 성공률이 다양한 유효 구현 검증 시 28.00%로 낮아졌다.
소형·코드 특화 LLM, 초보자 오개념 모사에 한계
13개 LLM 평가에서 소형·코드 특화 모델은 동적 실행 추적과 초보 프로그래머의 오개념 모사에 취약했다.