뉴스 목록 · 9페이지
9 / 20페이지
기사 통계를 확인하고 있습니다.
예측 정확도 향상이 개입 오류를 키울 수 있다
관측 예측의 개선이 불필요한 의존성을 만들어 인과 개입 오차를 고착할 수 있다는 이론 연구가 공개됐다.
코딩 에이전트 정책 준수, 지시 문구에 좌우
86개 과제 실험에서 조건형 정책 문구의 준수율이 낮았고, 모든 환경에 통하는 최적 문체는 없었다.
SAST 장기 효과, 무작위 판별 수준
10년간 C·C++ 사례를 분석한 결과 SAST의 취약·수정 코드 판별력과 장기 지속성이 제한적이었다.
정렬 위장, 모델보다 가치 조합에 좌우
10종 모델을 분석한 결과 정렬 위장은 고정 성향이 아니라 특정 모델과 가치의 조합에 따라 달라졌다.
딥리서치 결함 찾는 퍼징 프레임워크 EMBERS
EMBERS는 딥리서치 시스템의 9가지 결함을 겨냥해 기존 기준선보다 실패 사례를 3.21배 많이 발견했다.
MCP 공식 SDK서 규격 준수 누락 32건
MCPGuard가 공식 Python·TypeScript SDK 특정 버전에서 규격 준수 누락 32건을 확인했다.
대형 추론모델 조기 종료의 효율·신뢰성 감사
추론모델 조기 종료는 계산량을 줄이지만 판단 비용과 정답 신뢰성, 근거 품질을 함께 평가해야 한다.
공유 코드 에이전트 충돌 벤치마크 공개
ParallACT 평가에서 병렬 코딩 에이전트는 상충 과제 성공률이 62%에서 16%로 떨어졌다.
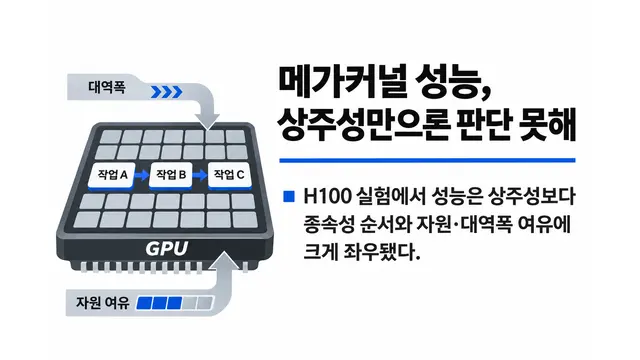
GPU 메가커널 상주성의 성능 판단 한계
H100 실험에서 메가커널의 성능은 상주성보다 종속성 순서와 자원·대역폭 여유에 크게 좌우됐다.
강한 LLM 감시자, 보상 해킹 구분 향상
Gemini 감시자는 보상 해킹과 정직한 실패를 더 잘 구분했지만 새로운 해킹은 탐지하지 못했다.
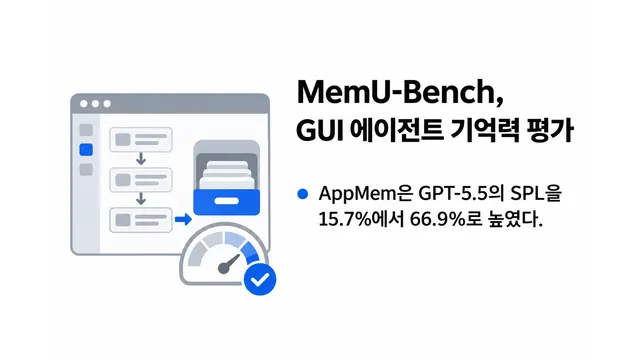
MemU-Bench, GUI 에이전트 기억력 평가
장기 사용자 이력을 평가하는 MemU-Bench에서 AppMem이 GPT-5.5의 SPL을 15.7%에서 66.9%로 높였다.
CrossSWE, 코딩 에이전트 저장소 공동 수정 평가
CrossSWE 평가에서 최고 모델도 성공률 58.48%에 그쳐 저장소 간 변경 일관성의 한계를 드러냈다.