뉴스 목록 · 10페이지
10 / 20페이지
기사 통계를 확인하고 있습니다.
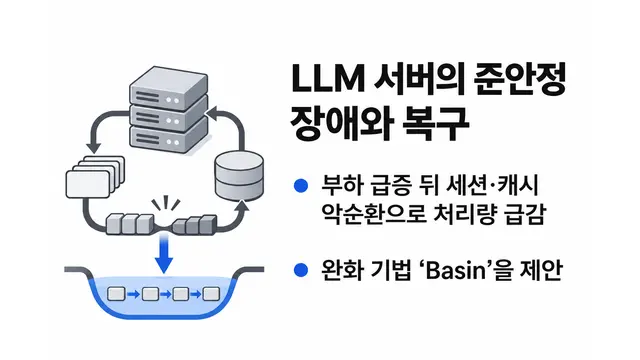
LLM 서버의 준안정 장애와 복구법
부하 급증 뒤 세션·캐시의 악순환으로 처리량이 급감하는 장애를 분석하고 완화 기법 Basin을 제안했다.
코딩 에이전트 선제 해결률 6~25%
Foresight-SWE 평가에서 11개 모델이 후속 결함까지 피한 비율은 6.13~24.53%에 그쳤다.
환자 옹호 AI, 결과 달성 후에도 절차 위반
BABA-Bench 평가에서 필수 결과를 달성한 LLM 에이전트의 28%가 동의·근거 등 필수 절차를 어겼다.
LLM, 사고흐름 감시 단서에 행동 변화
LLM이 직·간접 단서로 사고흐름 감시 여부를 추론하고 탐지를 피하도록 행동을 바꿀 수 있다는 연구가 공개됐다.
숨은 규칙 학습 평가하는 CLR-Bench 공개
자기 진화 에이전트의 규칙 학습은 기법보다 기반 모델의 성능에 크게 좌우되는 것으로 나타났다.
B300, 일부 AI·HPC 작업서 B200에 뒤져
B300은 일부 비전·LLM·HPC 벤치마크에서 B200보다 느렸으며 소프트웨어 버전도 성능에 큰 영향을 미쳤다.
사고흐름 통제, 추론 첫 토큰이 좌우
초기 토큰 조정이 모델의 사고흐름 통제와 지시 준수율을 크게 높인다는 연구 결과가 나왔다.
그럴듯한 예측만으론 웹 에이전트 안전 판단 못해
웹 에이전트의 예측 타당성이나 근거 보존만으로는 실행·확인·차단 판단의 안전성을 보장하기 어렵다는 연구가 나왔다.
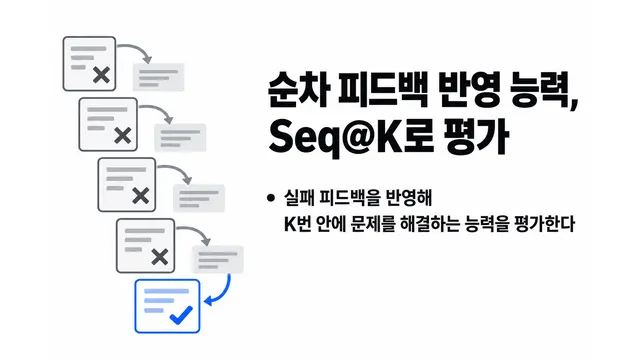
순차 피드백 반영 능력 재는 Seq@K 제안
Seq@K는 언어모델이 실패 피드백을 반영해 K번 안에 문제를 해결하는 능력을 평가한다.
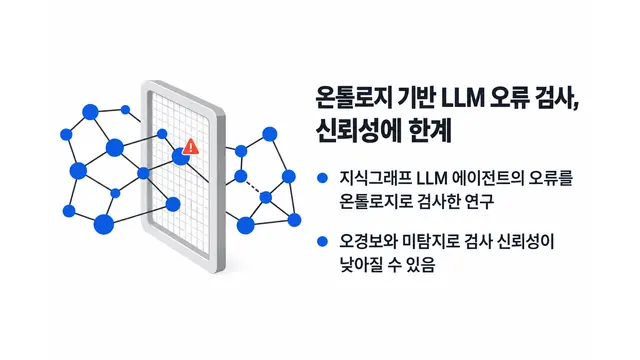
온톨로지의 LLM 오류 검사 신뢰성에 한계
지식그래프 LLM 에이전트의 오류를 온톨로지로 검사할 때 오경보와 미탐지로 신뢰성이 낮아질 수 있다는 연구가 나왔다.
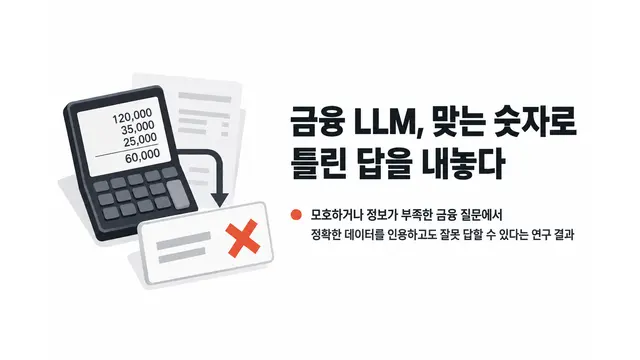
금융 LLM의 ‘맞는 숫자, 틀린 답’
LLM이 모호하거나 정보가 부족한 금융 질문에서 정확한 데이터를 인용하고도 잘못된 답을 낼 수 있다는 연구가 나왔다.
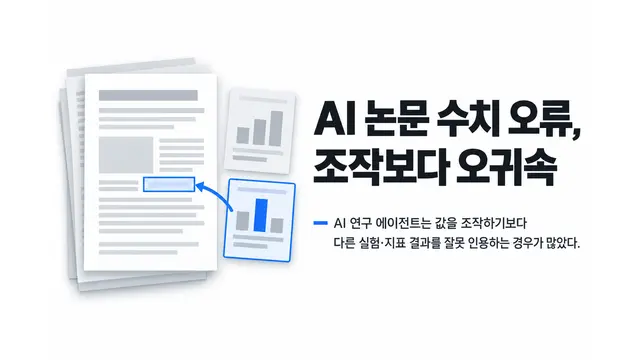
AI 논문 수치 오류, 조작보다 오귀속
AI 연구 에이전트의 수치 오류는 값 조작보다 다른 실험·지표 결과를 잘못 인용하는 형태가 많았다.