소프트웨어
61건
기사 통계를 확인하고 있습니다.
CyberGym 재현 성공률 85.3%→78.8%
과제 자료 불일치와 비목표 결함을 반영하자 CyberGym의 취약점 재현 통과율이 6.5%p 낮아졌다.
소형 오픈 모델의 SEC 공시 분석 격차
소형 모델도 SEC 공시에서 수치와 근거를 찾았지만 정확도 편차와 자동 검증의 허점이 컸다.
Claude가 생성한 검증으로 Rust SDP 솔버 증명
연구진이 직접 구현한 Rust SDP 솔버의 정확성을 Claude가 생성한 Verus 코드로 형식 검증했다.
코딩 에이전트 스킬 호출률 측정 연구
4개 실행 환경과 2개 모델에서 스킬 호출의 일관성을 2만400회 실험으로 검증하는 연구가 공개됐다.
AI 에이전트의 CI/CD 수정 위험 2.3배
93만여 건의 PR 분석에서 AI 에이전트의 CI/CD 통제 영역 수정 위험이 일반 작업보다 2.3배 높았다.
토큰 한도 고지, 코딩 에이전트 성능 개선 못해
위약 대조 실험에서 토큰 한도 고지는 코딩 에이전트의 문제 해결률을 유의미하게 높이지 못했다.
AI 공개보다 직급이 코드 리뷰에 영향
AI 활용이 일상화된 조직의 실험에서 AI 사용 공개는 불이익이 없었지만 작성자 직급은 평가를 좌우했다.
AI, 에이전트 지침 결함 탐지율 3.9% 이하
AI는 에이전트 지침 파일에서 사람이 찾은 문제의 1.3~3.9%만 탐지해 인간 검토를 대체하지 못했다.
오픈소스 ‘AI 슬롭’ PR 증가 양상 분석
유지관리자가 AI 슬롭으로 판정한 PR은 2026년 5월 정점을 찍었고 대부분 병합되지 않은 채 3일 안에 닫혔다.
GPU 커널 검증기 오류·오탈락 확인
두 연구가 LLM 생성 GPU 커널 검증기에서 오류 누락과 정상 후보 탈락 문제를 확인했다.
모바일 포렌식 기록 보존기간 실측
iOS·안드로이드 추출 자료 55건을 분석한 결과 저장소별 기록 보존기간이 수분에서 수년까지 달랐다.
코드 수명 측정법이 연구 결론 바꾼다
타입스크립트 저장소 120곳을 분석한 결과, 코드 수명 측정 오류 10가지가 연구 결론에 영향을 미쳤다.
CAD 에이전트 ‘조용한 실패’ 벤치마크 공개
측정 후 완료를 선언하게 하자 CAD 에이전트의 조용한 실패율이 14.1%에서 3.2%로 낮아졌다.
LLM 코드 안전성, 기본 설정에 좌우
LLM의 데이터베이스 코드는 자동 커밋 환경에서 절반 이상 불완전한 갱신을 남겼다.
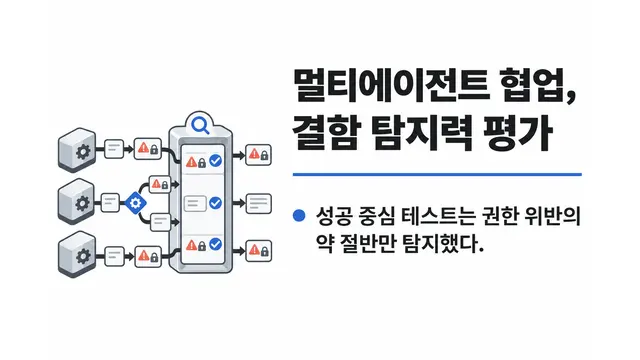
멀티에이전트 협업 결함 탐지력 평가
멀티에이전트 워크플로 변이 실험에서 성공 중심 테스트는 권한 위반의 약 절반만 탐지했다.
에이전트 앱 레드팀 벤치마크 GreyZone 공개
GreyZone은 실제 에이전트 앱에서 자동 생성 공격이 보안 정책 위반을 일으키는 능력을 평가한다.
LLM의 MongoDB 질의 예측력 평가
MongoBench 평가에서 LLM의 MongoDB 질의 결과 예측 정확도는 70.1~92.1%로 나타났다.
코딩 에이전트 프로젝트 인수 완수율 4.95%
37개 과제 평가에서 코딩 에이전트는 요구사항 복원과 구현에 모두 어려움을 보였다.
SWEOps-Bench, 클라우드 장애 복구 능력 평가
55개 재현 과제로 자율 에이전트를 평가한 결과 탐지율은 높았지만 전체 복구율은 14.5~52.7%에 그쳤다.
코딩 에이전트 벤치마크 타당성 점검
연구진은 코딩 벤치마크 9개의 지표와 교란 요인을 분석하고 구성 타당도 강화 필요성을 제기했다.
상용 텍스트 임베딩서 원문 복원 위험 확인
vec2text 실험에서 상용 임베딩만으로 건강 지시문 등 원문의 상당 부분을 복원할 수 있는 것으로 나타났다.
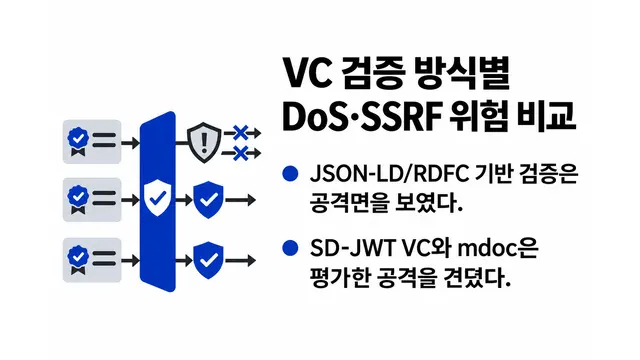
VC 검증 파이프라인의 DoS·SSRF 위험 비교
JSON-LD/RDFC 기반 VC 검증은 공격면을 보인 반면 SD-JWT VC와 mdoc은 평가한 공격을 견뎠다.
코딩 에이전트 정책 준수, 지시 문구에 좌우
86개 과제 실험에서 조건형 정책 문구의 준수율이 낮았고, 모든 환경에 통하는 최적 문체는 없었다.
SAST 장기 효과, 무작위 판별 수준
10년간 C·C++ 사례를 분석한 결과 SAST의 취약·수정 코드 판별력과 장기 지속성이 제한적이었다.
CrossSWE, 코딩 에이전트 저장소 공동 수정 평가
CrossSWE 평가에서 최고 모델도 성공률 58.48%에 그쳐 저장소 간 변경 일관성의 한계를 드러냈다.
코딩 에이전트 선제 해결률 6~25%
Foresight-SWE 평가에서 11개 모델이 후속 결함까지 피한 비율은 6.13~24.53%에 그쳤다.
생성형 AI 시대, 개발자의 ‘인지 부채’
AI 생성 코드를 이해 없이 수용하면 유지보수와 디버깅을 어렵게 하는 인지 부채가 누적될 수 있다.
오픈소스 PQC 커밋 90%는 유지보수
179개 저장소 분석 결과 PQC 작업은 신규 도입보다 유지보수와 빌드 안정성 확보에 집중됐다.
LLM 함수 간 추론 평가 ICALL-BENCH 공개
바이너리 간접 호출 복원 평가에서 LLM의 검증 가능 성공률은 23~81%로 나타났다.
코딩 에이전트 메모리 파일의 보안 위험
프로젝트 메모리 파일이 지시 주입 경로로 악용될 수 있지만, 보안 영향은 에이전트별로 일관되지 않았다.
AI 코딩으로 PR 2배, 리뷰 부담도 2배
AI 코딩 도구가 개발자의 PR 처리량을 늘렸지만 리뷰어 부담도 2배로 키웠다는 연구가 나왔다.
LLM 추론 토큰 증가, 코딩 정확도 보장 못해
파이썬 과제 866개를 분석한 결과, LLM의 추론 비용 증가가 코딩 정확도 향상으로 이어지지는 않았다.
효과 유형 학습으로 도구 호출 안전성 향상
이펙트월드로 학습한 Qwen3-4B가 위험한 도구 호출을 줄이며 과제 성공률과 효율을 높였다.
코딩 에이전트, 최적화 후에도 리팩터링 지속
반복 리팩터링 실험에서 코딩 에이전트들이 최적화된 코드를 인식하지 못하고 불필요한 수정을 이어갔다.
코딩 에이전트, 재시작보다 계속 실행이 효율적
초기 실패 예측은 시도별 성공을 가리지 못해 대부분 조건에서 재시작보다 계속 실행하는 편이 효과적이었다.
웹 개발 에이전트 데이터셋 WebUniverse 공개
실행 가능한 웹 개발 과제 1만5천 개와 검증된 개발 궤적으로 모델 성능 향상을 보고했다.
LLM 에이전트의 메모리·스킬 충돌 측정
벤치마크 실험에서 LLM의 정보원 선택은 충돌 유형과 모델, 주입 순서에 따라 달라졌다.
도구 명세 변경 막는 ToolContractGate 공개
승인 당시 OpenAPI 계약과 실행 시점 명세를 비교해 도구 호출 드리프트를 탐지하는 평가기가 공개됐다.
형식 라이브러리 설명의 귀속성 검증법 제안
연구진은 함수 고유 동작에 근거한 설명을 선별하고 증거를 제공하는 문서 생성법 DocAuth를 제안했다.
GUI 에이전트 실제 실패 335건 분석
연구진이 GUI 에이전트의 도구 매개 상호작용 실패 335건을 11가지 유형으로 분류했다.
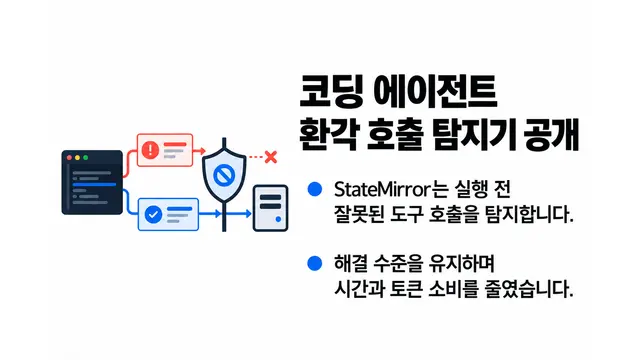
코딩 에이전트 환각 호출 탐지기 공개
StateMirror는 실행 전 잘못된 도구 호출을 탐지해 해결 수준을 유지하며 시간과 토큰 소비를 줄였다.
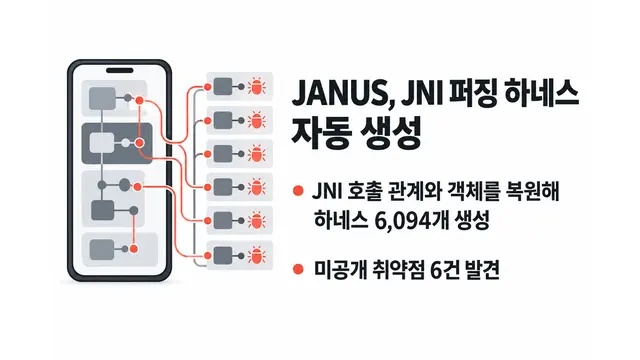
JANUS, 안드로이드 JNI 퍼징 하네스 자동 생성
JANUS는 JNI 호출 관계와 객체를 복원해 하네스 6,094개를 만들고 미공개 취약점 6건을 발견했다.
낡은 지침 우선한 코딩 에이전트
코딩 에이전트가 낡은 지침을 코드보다 우선했지만 기존 코드를 따르라는 문장으로 오류가 줄었다.
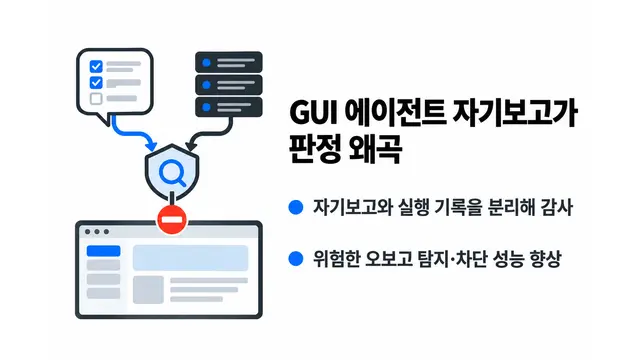
GUI 에이전트 자기보고가 판정 왜곡
자기보고와 실행 기록을 분리한 감사기가 위험한 오보고 탐지와 차단 성능을 높였다.
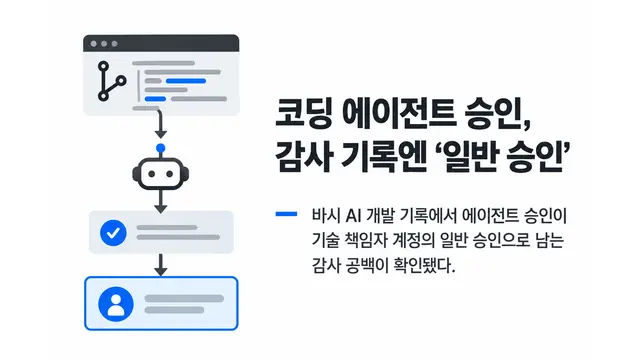
코딩 에이전트 승인에 감사 공백 확인
바시 AI 개발 기록에서 에이전트 승인이 기술 책임자 계정의 일반 승인으로 남는 감사 공백이 확인됐다.
양자 코드 LLM 점수, 평가기 결함에 출렁
감사 결과 양자 코드 LLM 벤치마크의 설계와 결함이 점수 왜곡과 거짓 통과·실패를 유발했다.
LLM 생성 PLC 코드, 컴파일돼도 오류
PLC 코드를 매 실행 주기 검사한 결과, LLM 생성 코드의 실행 통과율은 컴파일 통과율보다 11.92%p 낮았다.
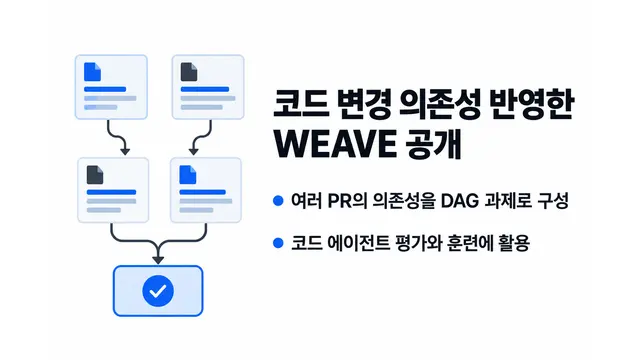
코드 변경 의존성 반영한 WEAVE 공개
WEAVE는 여러 PR의 의존성을 DAG 과제로 구성해 코드 에이전트 평가와 훈련에 활용한다.
전체 파일 선택, 코딩 에이전트 성능 향상
CQ2-CARE는 수정할 파일의 원문 전체를 제공해 코드 압축·검색 방식보다 높은 이슈 해결률을 기록했다.
AI 작성 PR, 더 강한 검증 요구받아
개발자들은 AI 작성 PR을 덜 신뢰하며 더 강한 증거와 명확한 책임 소재를 요구한다는 조사 결과가 나왔다.
코드 리뷰 에이전트, 버그 71.9% 탐지
CRBugBench 평가에서 최신 리뷰 에이전트는 성능이 향상됐지만 복잡한 변경과 기업 저장소에서는 한계를 보였다.
코딩 에이전트 테스트 결함 탐지력 60% 미만
TestSuiteBench에서 최신 코딩 에이전트는 테스트 통과율은 높았지만 변이 점수 60%를 넘지 못했다.
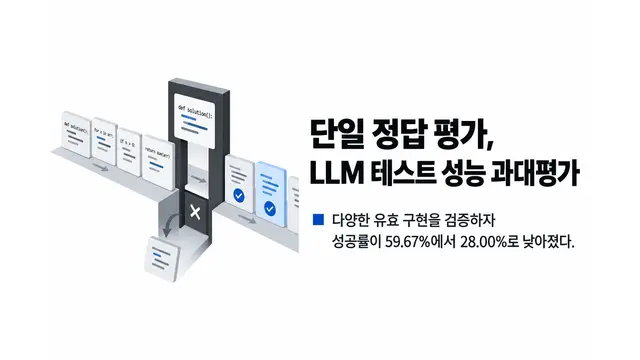
단일 정답 평가, LLM 테스트 품질 과대평가
TestPrism 연구에서 단일 정답 기준 59.67%였던 성공률이 다양한 유효 구현 검증 시 28.00%로 낮아졌다.
소형·코드 특화 LLM, 초보자 오개념 모사에 한계
13개 LLM 평가에서 소형·코드 특화 모델은 동적 실행 추적과 초보 프로그래머의 오개념 모사에 취약했다.
IRONPROOF, COBOL 변환 검증의 한계
SMT로 COBOL과 Python의 동등성을 606건 증명했지만 입력 모델링과 실제 구현 검증에는 한계가 있었다.
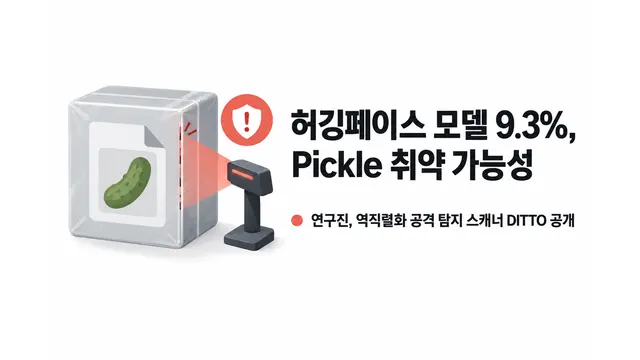
허깅페이스 모델 9.3% Pickle 취약 가능성
연구진이 Pickle 모델의 역직렬화 공격을 탐지하는 문맥 인식형 스캐너 DITTO를 공개했다.
AI 에이전트 스킬 복제 경로 첫 추적
GitHub 스킬 도입 219만여 건을 분석해 복제 집중과 보안 수정 전파 단절을 확인했다.
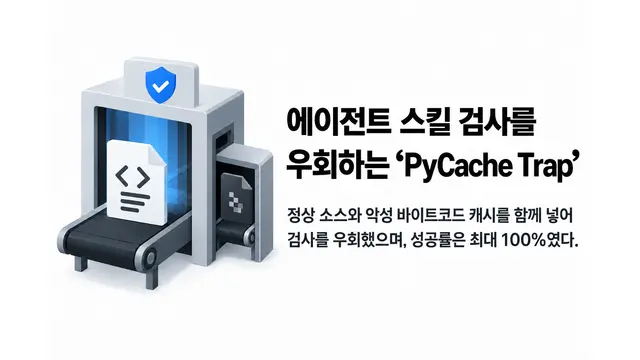
에이전트 스킬 검사 우회하는 ‘PyCache Trap’
정상 소스와 악성 바이트코드 캐시를 함께 넣어 검사를 우회하는 기법이 최대 100% 성공률을 보였다.
AgentTracer, 간접 프롬프트 주입 경로 추적
AgentTracer는 LLM 에이전트의 의도 이탈을 탐지해 주입 지점과 공격 경로를 높은 정확도로 복원한다.
LLM 취약점 패치 평가, 설계 따라 성능 왜곡
높은 PoC 통과율이 근본 원인 해결이나 개발자 의도에 맞는 패치 품질을 보장하지 않는다는 연구가 나왔다.
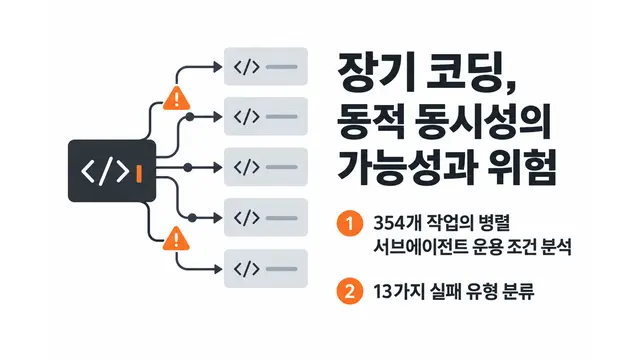
장기 코딩의 동적 동시성 가능성과 위험
354개 작업을 분석해 병렬 서브에이전트 운용 조건과 13가지 실패 유형을 분류했다.