언어모델
10건
기사 통계를 확인하고 있습니다.
희귀 행동 표본추출 벤치마크 공개
PosteriorBench 평가에서 희귀 행동의 실제 조건부 분포를 저비용으로 충실히 재현한 방법은 없었다.
언어모델의 숨은 행동 감시 기법 제안
관찰자 역할을 훈련한 Qwen 모델이 숨은 행동 감시 평가에서 평균 AUROC 0.907을 기록했다.
장문 생성 성능 저하, 샘플링이 원인
고온 설정에서 후보 토큰을 제한한 top-nsigma가 오픈 모델의 장문 생성 성능을 유지했다.
27B 언어모델, 스스로 가중치 고쳐 성능 향상
27B 모델이 추가 훈련 없이 자체 가중치를 수정해 정확도를 6.6%포인트 높였지만 소형 모델은 실패했다.
LoRA 모델 아티팩트로 학습 분야 추론
가중치·활성값·생성문을 분석해 LoRA 모델의 학습 데이터 분야를 최고 64% 정확도로 분류했다.
정렬 위장, 모델보다 가치 조합에 좌우
10종 모델을 분석한 결과 정렬 위장은 고정 성향이 아니라 특정 모델과 가치의 조합에 따라 달라졌다.
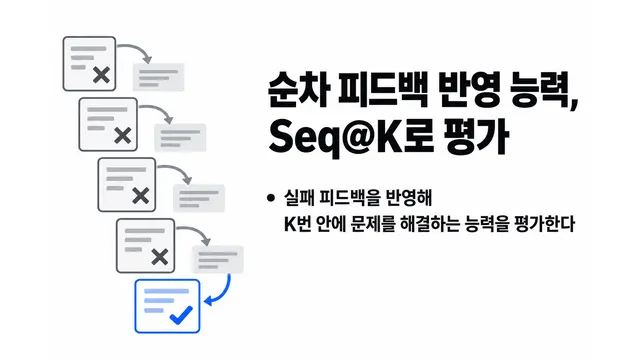
순차 피드백 반영 능력 재는 Seq@K 제안
Seq@K는 언어모델이 실패 피드백을 반영해 K번 안에 문제를 해결하는 능력을 평가한다.
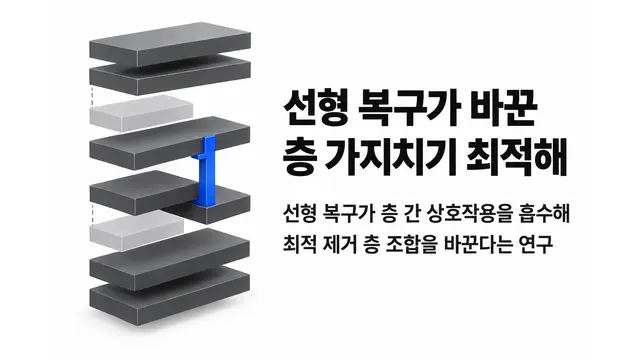
복구 방식이 언어모델 층 가지치기 최적해 바꿔
선형 복구가 층 간 상호작용을 흡수해 언어모델 깊이 가지치기의 최적 제거 층 조합을 바꾼다는 연구가 나왔다.
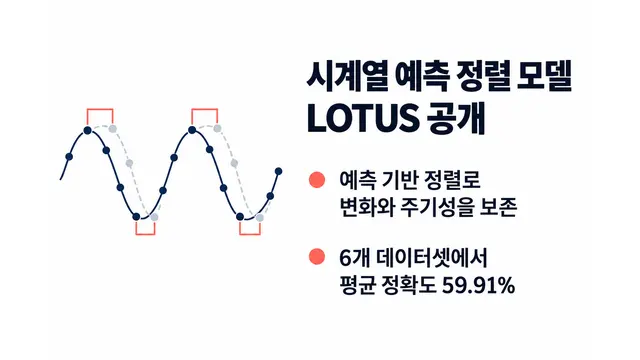
시계열 예측 정렬 모델 LOTUS 공개
LOTUS는 예측 기반 정렬로 시계열의 변화와 주기성을 보존해 6개 데이터셋에서 평균 정확도 59.91%를 기록했다.
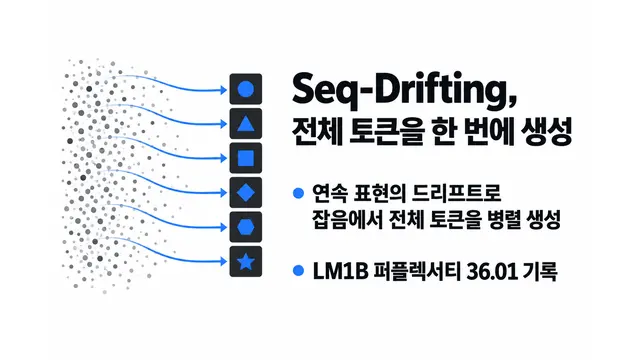
Seq-Drifting, 한 번에 전체 토큰 생성
연속 표현의 드리프트로 잡음에서 전체 토큰을 병렬 생성해 LM1B 퍼플렉서티 36.01을 기록했다.